
Claude CodeとObsidianを連携させる仕組み(MCP)とは
Obsidianに溜めたノートを、AIエージェントに直接読み書きさせたい。そう考えたときに出てくるのが「MCP(Model Context Protocol)」という仕組みだ。
MCPとは何か
MCP(Model Context Protocol)は、AIエージェントが外部のツールやデータソースにアクセスするための標準プロトコルだ。MCPを実装したObsidianプラグインを導入すると、Claude CodeやClaude DesktopのようなMCPクライアントが、Obsidianのノート(Vault)に直接アクセスできるようになる。
これにより、次のような操作をAIエージェントに任せられるようになる。
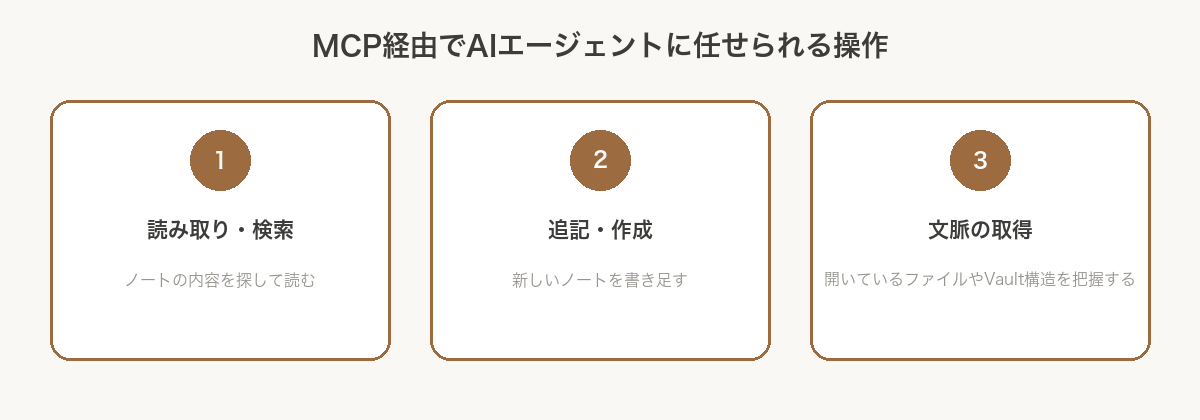
- ノートの読み取り・検索
- 新しいノートの追記・作成
- 現在開いているファイルやVaultの構造といった、作業中の文脈の取得
どういう技術的な仕組みで動いているか
MCPサーバーの実装にはいくつかバリエーションがあるが、一般的には次のような構成になっている。
- Claude Code向けにはWebSocket、Claude Desktop向けにはHTTP/SSEの両方をサポートする実装が多い
- 自動検出機能により、Claude Code側がVaultを自動的に見つけて接続できる
- ファイル操作に加えて、現在アクティブなファイルやVault構造といった「ワークスペースの文脈」もAIに渡せる
- Obsidianには2026年に公式CLIも導入され、ターミナルからノートの作成・読み取り・追記・移動・削除・Vault全体検索・タグ/バックリンクの取得などが可能になっている
導入の流れも大まかに把握しておくと判断しやすい。ObsidianにMCP対応プラグインをインストールし、プラグイン側でサーバーを起動する。次にClaude Code側の設定ファイルにMCPサーバーの接続情報を追加すると、以降はセッションを開くたびに自動的にVaultへ接続される。この設定は最初の一度だけで済み、日々の利用では意識する必要がない。
安全性はどう担保されているか
「AIにVaultを直接触らせる」と聞くと、ノートがどこかにアップロードされるのではと心配になるかもしれない。だが、MCPサーバー自体はローカルマシン上で動作する設計が一般的だ。Vaultの内容はディスクから読み込まれ、AIがそのツールの呼び出しを実際に選択したときにだけAIへ渡される。
これは、クラウド型のメモアプリにAI連携機能を追加する場合とは根本的に異なる。クラウド型では、そもそもノート自体が常時サーバー側に存在しているため、「AIに見せるかどうか」という境界を後から設けにくい。MCP経由のObsidian連携では、Vaultがローカルにある前提そのものが、境界線をシンプルに保ってくれる。
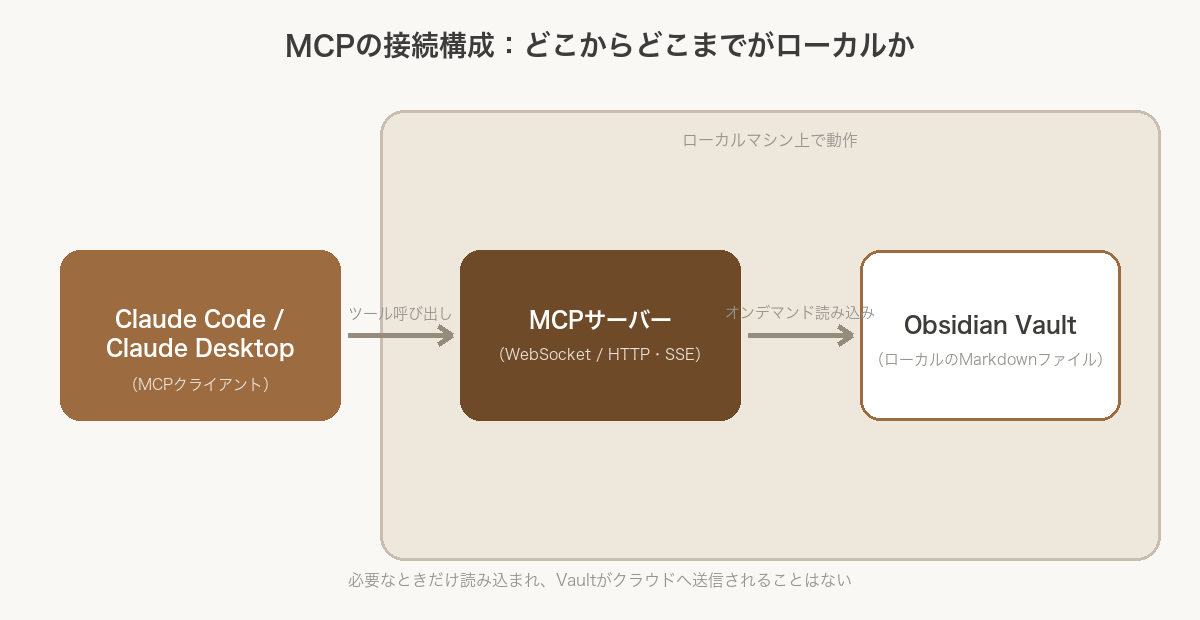
ローカルで動作し、必要なときだけオンデマンドで読み込むという設計が、Vaultをクラウドに預けることなくAI連携を実現する基盤になっている。ノート本体がプレーンなMarkdownファイルであることも、特定のサービスへの依存を避けやすくしている理由の一つだ。
連携して何ができるようになるのか
技術的な仕組みだけを見ても実感が湧きにくいので、実務でどう使われているかを紹介する。
個人のナレッジベース構築の事例では、AIエージェントにVaultを直接読み書きさせて、要約作成やMOC(Map of Content、目次的な役割のノート)の更新作業を任せるサイクルで、知識の蓄積スピードを上げている例が報告されている。人間が全てのノートを整理・要約するのではなく、「情報を書く」「AIが整理して構造化する」という役割分担にすることで、蓄積の摩擦を下げる狙いがある。
具体的には、その日書いたフリートノートをAIエージェントに読ませ、「関連する既存ノートがあればリンクを提案して」「内容が薄いノートは、関連する永久ノートへの統合を提案して」といった指示を出す運用が考えられる。人間は書くことに集中し、リンク付けや整理という手間のかかる作業をAIが肩代わりする。このサイクルを回し続けると、Vault全体が徐々に構造化されていく。
 あたま
「情報を書く」のは人間、「整理して構造化する」のはAI、という役割分担にしてから、書くこと自体への心理的なハードルがかなり下がりました。整理は後からAIに任せればいい、と思えるからだと思います。
個人の効率化から、チームで使える仕組みへ
ここまではAIエージェントとObsidianを技術的につなぐ話だった。この仕組みを応用すると、個人のメモ効率化を超えて、「複数人が同じナレッジベースを、AIを介して参照する」という使い方もできるようになる。
実際に、研究の現場でこの仕組みを使って、属人化しがちな実験ノウハウを複数人が引き出せる形にした例がある。次の記事では、なぜ研究の現場でノウハウが特に失われやすいのか、そしてAIエージェントがそこにどう関わるのかを整理する。
関連記事

コメント