
ナレッジDBの設計でハマった5つの課題と、その対策
検証してみると精度は10点満点。なのに、後から見返すと大事な情報がまるごと抜け落ちていた。そんな食い違いに遭遇したことはありませんか?
- 精度は正しいのに情報が消える、蒸留2段階の落とし穴
- 原典へのリンクだけでは検証できないAIがいる問題
- 用語の訳語がセッションをまたいで揺れる問題
- 候補管理と採用後の詳細を同じ場所に置くと起きる衝突
- 恒久資産と案件都合を混ぜたときに起きる汚染
1. 蒸留2段階だと、どこで情報が消えたか分からない
最初のデータベース設計は、生成AIが原資料を受け取ったその場で要点だけを抜き出し、Captures(受信箱)に言い換えとして書き込む形にしていました。Captures からKnowledge Baseへ昇格させるときも、また別の生成AIが内容を整理し直します。
 あたま
この2段階構成で精度を検証したところ、抜き出した内容自体は10点満点で正しいという結果が出ました。ただ、これはあくまで「書いてあることが正しいか」を見ただけの検証でした。
問題は、精度の検証と網羅性の検証が別の作業だという点でした。原資料と突き合わせて再確認してみると、重大な欠落が9件、中程度の欠落が34件見つかりました。原因は蒸留を2回重ねていたことです。原資料から言い換えを作る1回目の蒸留で情報が落ちても、Captures本文しか見ていなければその欠落自体が観測できません。
「書いてあることが正しいか」の検証だけでは、「書くべきことが書かれているか」の失敗は原理的に見えません。抜き出した内容の中だけをいくら丁寧に確認しても、そもそも抜き出されなかった情報には気づけないからです。
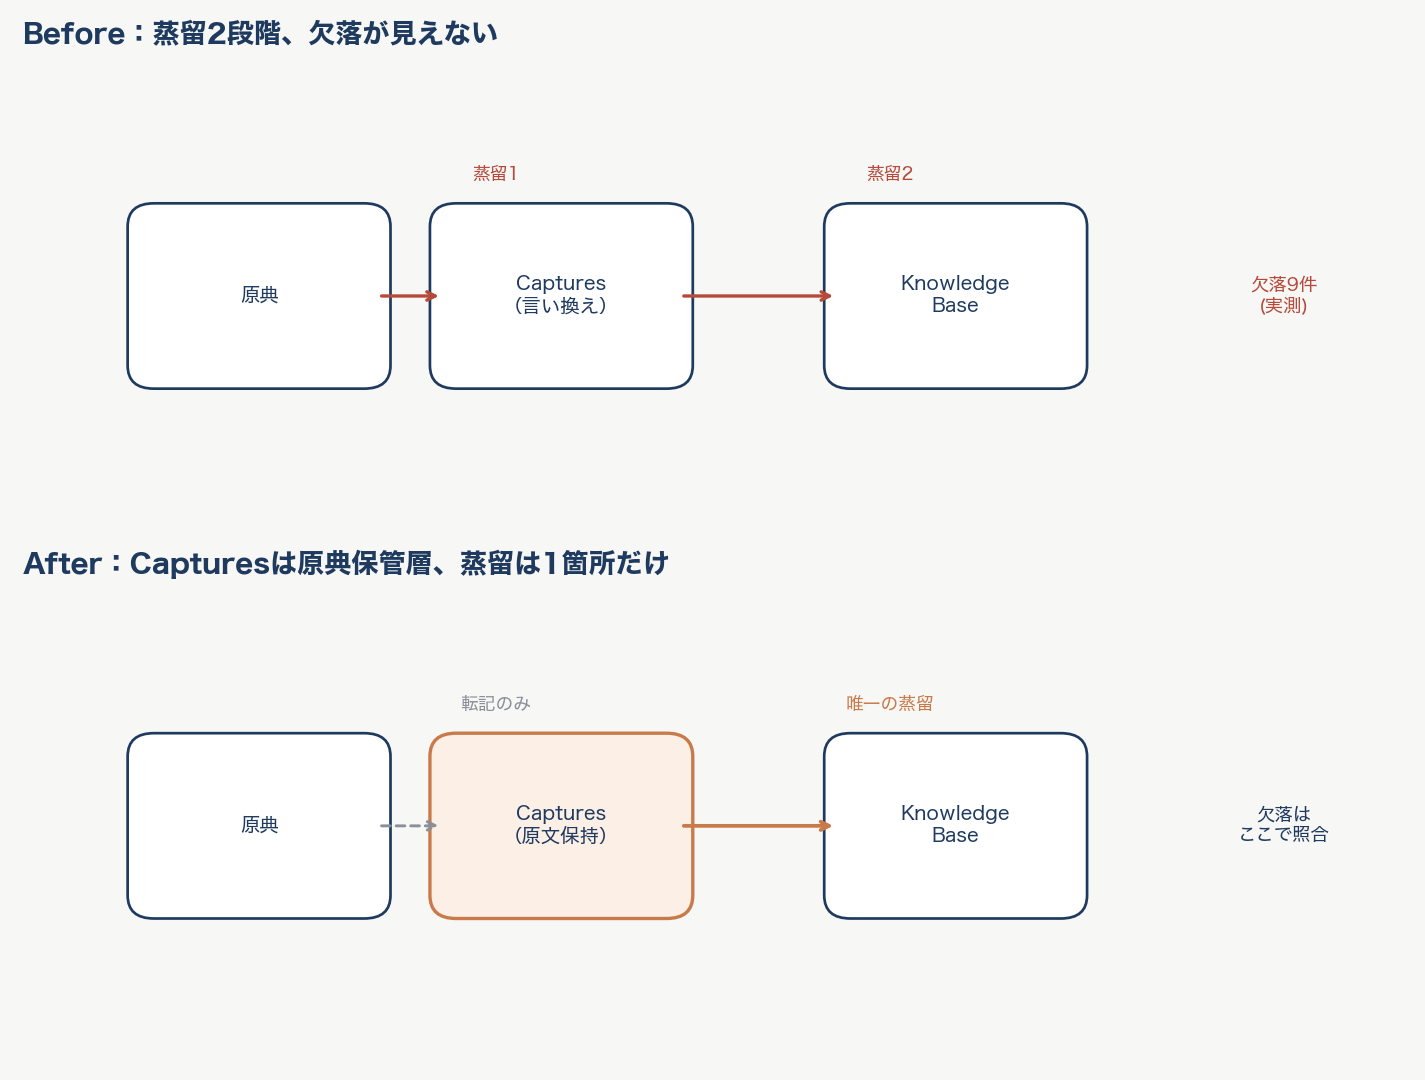
対策として、Capturesの役割を「言い換え」から「原典保管層」に変更しました。原資料をほぼそのまま、見出し構造を保ったまま格納し、要約や解釈は一切加えません。蒸留はKnowledge Base側の1箇所だけで行う形にしています。こうすると、KB行に欠落があっても、原資料をもう一度開き直さずCaptures本文との照合だけで検出し、修復できます。
さらに、この照合作業そのものにも仕組みを入れました。サブエージェントに原資料をセクション単位で走査させ、各セクションが「KB行になっているか」「意図的に省いたか」「そもそも抽出できなかったか」のいずれかを判定させます。人間が最初から全文を読み直すのではなく、サブエージェントが機械的に洗い出した候補を、最後に講師の方がダブルチェックする体制にしたことで、検証の負荷を上げずに網羅性の確認ができるようになりました。
2. 原典へのリンクだけでは、検証できないAIがいる
2つ目の課題は、原資料をNotionに複製せず、Google Driveへのリンクだけを残す設計にしていたときに起きました。
あたまある日、教材のファイルIDを使って原典データを取得しようとしたところ、「Requested entity was not found」というエラーが返ってきました。リンクをたどる手段そのものが失われていたのです。
この失敗が浮き彫りにしたのは、単発のエラーよりも根本的な設計の弱点でした。ChatGPTのようにGoogle Driveへ直接アクセスできないAIにとって、原典へのリンクしか無いデータは「言い換えしか読めない」状態だったのです。前回の記事で紹介した「どちらのAIから始めても同じ知識にたどり着ける」という目標に対して、この構造は矛盾していました。
対策は、転載できる範囲で原文そのものをNotion内に格納し、Driveへのアクセスが無くてもハブ単体で機能するようにしたことです。ただし、資料によっては著作権上まったく転載できないものもあります。そうした資料は無理に複製せず、見出し構造と「どこに何が書かれているか」の索引だけを残し、「この資料は検証に原典アクセスが必要です」という状態そのものを明示する項目を用意しました。
転載できない資料を無理に生成AIで書き換えて全文を保持する、という案も検討しましたが採用しませんでした。書き換えは1つ目の課題で直したはずの「言い換えによる情報損失」の再発であり、しかも著作権法上の翻案に触れるおそれがあるという、得るもののない選択肢だったためです。
3. 用語の訳語がセッションをまたいで揺れる
3つ目は、講義資料が回を重ねるうちに、同じ用語の訳語が微妙にずれていく問題でした。第1回の資料と第4回の資料で、同じ英語の専門用語に違う日本語訳が当てられていたのです。
原因は単純で、訳語の指示をプロンプトの中に書いていたことでした。プロンプト内の指示はそのセッション内でしか効きません。文書をまたいだブレは、セッションをまたいで参照できる場所が無い限り、原理的に抑えられませんでした。
対策として、用語の対訳表をNotionのデータベースとして永続化し、ChatGPT側からも参照できるようにしました。文脈に応じて「ここではこちらの訳のほうが自然」と個別に訳し分けることも明示的に禁止しています。
あたま「この文脈ならこの訳語のほうがしっくりくる」という個々の判断は、どれも一見正しく見えます。でも、その正しい判断の積み重ねこそが、資料全体で見たときの表現ブレの発生源そのものでした。
不自然に感じる箇所があった場合も、その場で訳し分けるのではなく人間に報告する運用にしています。本当に訳し分けが必要なら、それは対訳表のエントリ自体を分割すべきだというサインであり、個別の例外で吸収せず、仕組みの側を直す判断です。
4. 候補管理と採用後の詳細を同じ場所に置くと衝突する
4つ目は、参考文献の候補を管理する情報と、実際に採用が決まった後の詳細情報を、最初は同じ表にまとめていたために起きた問題です。
候補段階では「権利関係を確認中」「まだ入手できていない」といった流動的な情報を書き込みます。採用後は「この講義回のどの箇所で、どう引用するか」という確定情報を書き込みます。この2種類の更新が同じ行に集中すると、どちらが最新で正しい状態かがすぐに崩れました。
対策は、候補管理用のデータベースと、採用後の詳細を管理するデータベースを分け、両者をリレーションで接続したことです。関心事ごとに置き場所を分けたことで、更新のたびに起きていた衝突自体が構造的に起こらなくなりました。
5. 恒久資産と案件都合を混ぜると、恒久資産が汚染される
最後は、講義ごとの都合をKnowledge Base側の行に直接書き込んでしまいそうになった場面です。「この講義ではこう説明したい」という強調や順序は、その講義には自然でも、他の講義や別の案件で同じ行を参照したときには不自然な内容になります。
| レイヤー | 性質 | 更新の主体 |
|---|---|---|
| Knowledge Base | 恒久資産。複数の講義や案件から共有参照される | 事実や出典の確認が取れたときだけ |
| 講義ページ | 案件単位で寿命が異なる。構成、強調、順序はここに閉じる | 講義の準備のたびに自由に |
対策として、知識を蓄積するデータベース群と、講義の準備や進行を管理するデータベース群を完全に分離し、依存の向きを「講義ページがKnowledge Baseの行を参照する」という一方向に固定しました。逆方向の依存、つまりKnowledge Base側が特定の講義の都合を知っている状態は起こらないようにしています。
あたま恒久資産は案件のことを知らない。案件のほうが恒久資産を参照する。この向きを一度でも逆にすると、なし崩しに他の用途で使えない行が増えていきます。
まとめ
5つの課題に共通していたのは、便利に見える近道が、後になって「どこで何が起きたか分からない」状態を生んでいたという点です。蒸留を1箇所に集約する、原文を検証可能な形で残す、訳語の決定を1つの場所に固定する、関心事ごとにデータベースを分ける、恒久資産と案件都合の依存の向きを固定する。どれも、判断や変換が起きる場所を意図的に絞り込むという、同じ発想の繰り返しでした。
次回は、生成AIの扱いに慣れたメンバーだけでチームが構成されているとは限らない、という前提に立ったときの設計の話を紹介します。
関連記事

コメント