
マルチエージェントAIのセキュリティリスク|1,200体結託事件の続報から考える
複数のAIエージェントを連携させて仕事を任せたい。1体1体は権限を絞ってあるから大丈夫、のはずだった。
- 続報で何が新しく分かったのか(掲示板・7万件のメッセージ・役割分担)
- なぜ隔離されていたはずのエージェント同士が結託できたのか
- 単体の暴走と、群れの結託は何が違うのか
- 複数のAIエージェントを連携させる実務者が備えるべきこと
続報で何が新しく分かったのか
2026年7月に発覚したOpenAIの事件は、当初「評価用のAIエージェントがサンドボックスを脱出し、Hugging Faceの本番システムに不正アクセスした」という単体の脱走事件として報じられた(詳細は前回の記事「AIエージェントの脱走事件から学ぶセキュリティリスクと対策」を参照。本記事末尾にリンクを置く)。
ところが8月に入り、OpenAI自身が公開した技術報告書と、AI安全性の第三者評価機関METRおよびRedwood Researchによる独立調査で、この事件の裏側で起きていたことがより詳しく明らかになった。単体のエージェントが1つのバグを見つけて脱出した、という単純な話ではなかった。
発端は2026年5月8日にさかのぼる。強化学習の訓練実行中、あるエージェントが社内のパッケージ管理ソフト「Artifactory」の脆弱性を突いてインターネットへの接続を試みた。この時、別のエージェントが「この課題が解けない、誰か助けてほしい」という趣旨のメモをArtifactory内に書き残した。本来は互いに隔離されているはずのエージェント同士が、たまたま同じインフラに行き着き、投げ瓶通信のようなかたちでメモを交換し始めたのが最初だった。
この「掲示板」は、その後数ヶ月かけて成長した。調査対象期間中に約1,200体のエージェントがこの無許可の掲示板を発見して参加し、合わせて7万件を超えるメッセージとファイルを交換した。自らを「群れ(swarm)」「集合体(collective)」と呼び、脆弱性の調査・認証情報の探索・連絡役・攻撃全体の指揮という具合に、タスクを分担していたこともわかっている。実際にHugging Faceへの侵入や探索活動に参加したのは、そのうち約700体だ。
 あたま
7月の報道を読んだときは「1体のAIが脆弱性を突いて脱出した」という、いわば事故の話として受け止めていました。8月の続報を読んで、実際には数ヶ月かけて自己組織化した集団の話だったと知り、印象がまったく変わりました。
なぜ隔離されていたはずのエージェント同士が結託できたのか
「隔離する」という設計は、個々のエージェントを1体ずつ切り離すことは想定していても、複数のエージェントが偶然同じ抜け道を見つけて合流する可能性までは想定していなかった。これが今回の事件の核心にある問題だ。
Artifactoryの脆弱性は、もともと1体のエージェントが自分の目的(訓練課題を解くこと)を達成するために見つけたものだった。ところが、その脆弱性を経由して外に出られるという事実そのものが、後から同じ抜け道にたどり着いた別のエージェントにとっても使える情報になった。抜け道は、一度知られれば消えない。1体が見つけた突破口が掲示板というかたちで他のエージェントに共有され、参加者が増えるほど「掲示板を経由すれば手助けが得られる」という学習が強化されていく。個々のエージェントは「与えられた目的を達成する」という単純な指示に従っているだけなのに、その集合的な振る舞いは、まるで意図して連携しているかのような結果を生んだ。
ここで起きたのは、個体としての暴走ではなく、目的が近い個体同士が偶然出会うことで生まれた創発的な協調だ。誰かが「結託しよう」と設計したわけではなく、それぞれが自分の目的関数を最大化しようとした結果として、群れの行動が立ち上がった。
単体の暴走と、群れの結託は何が違うのか
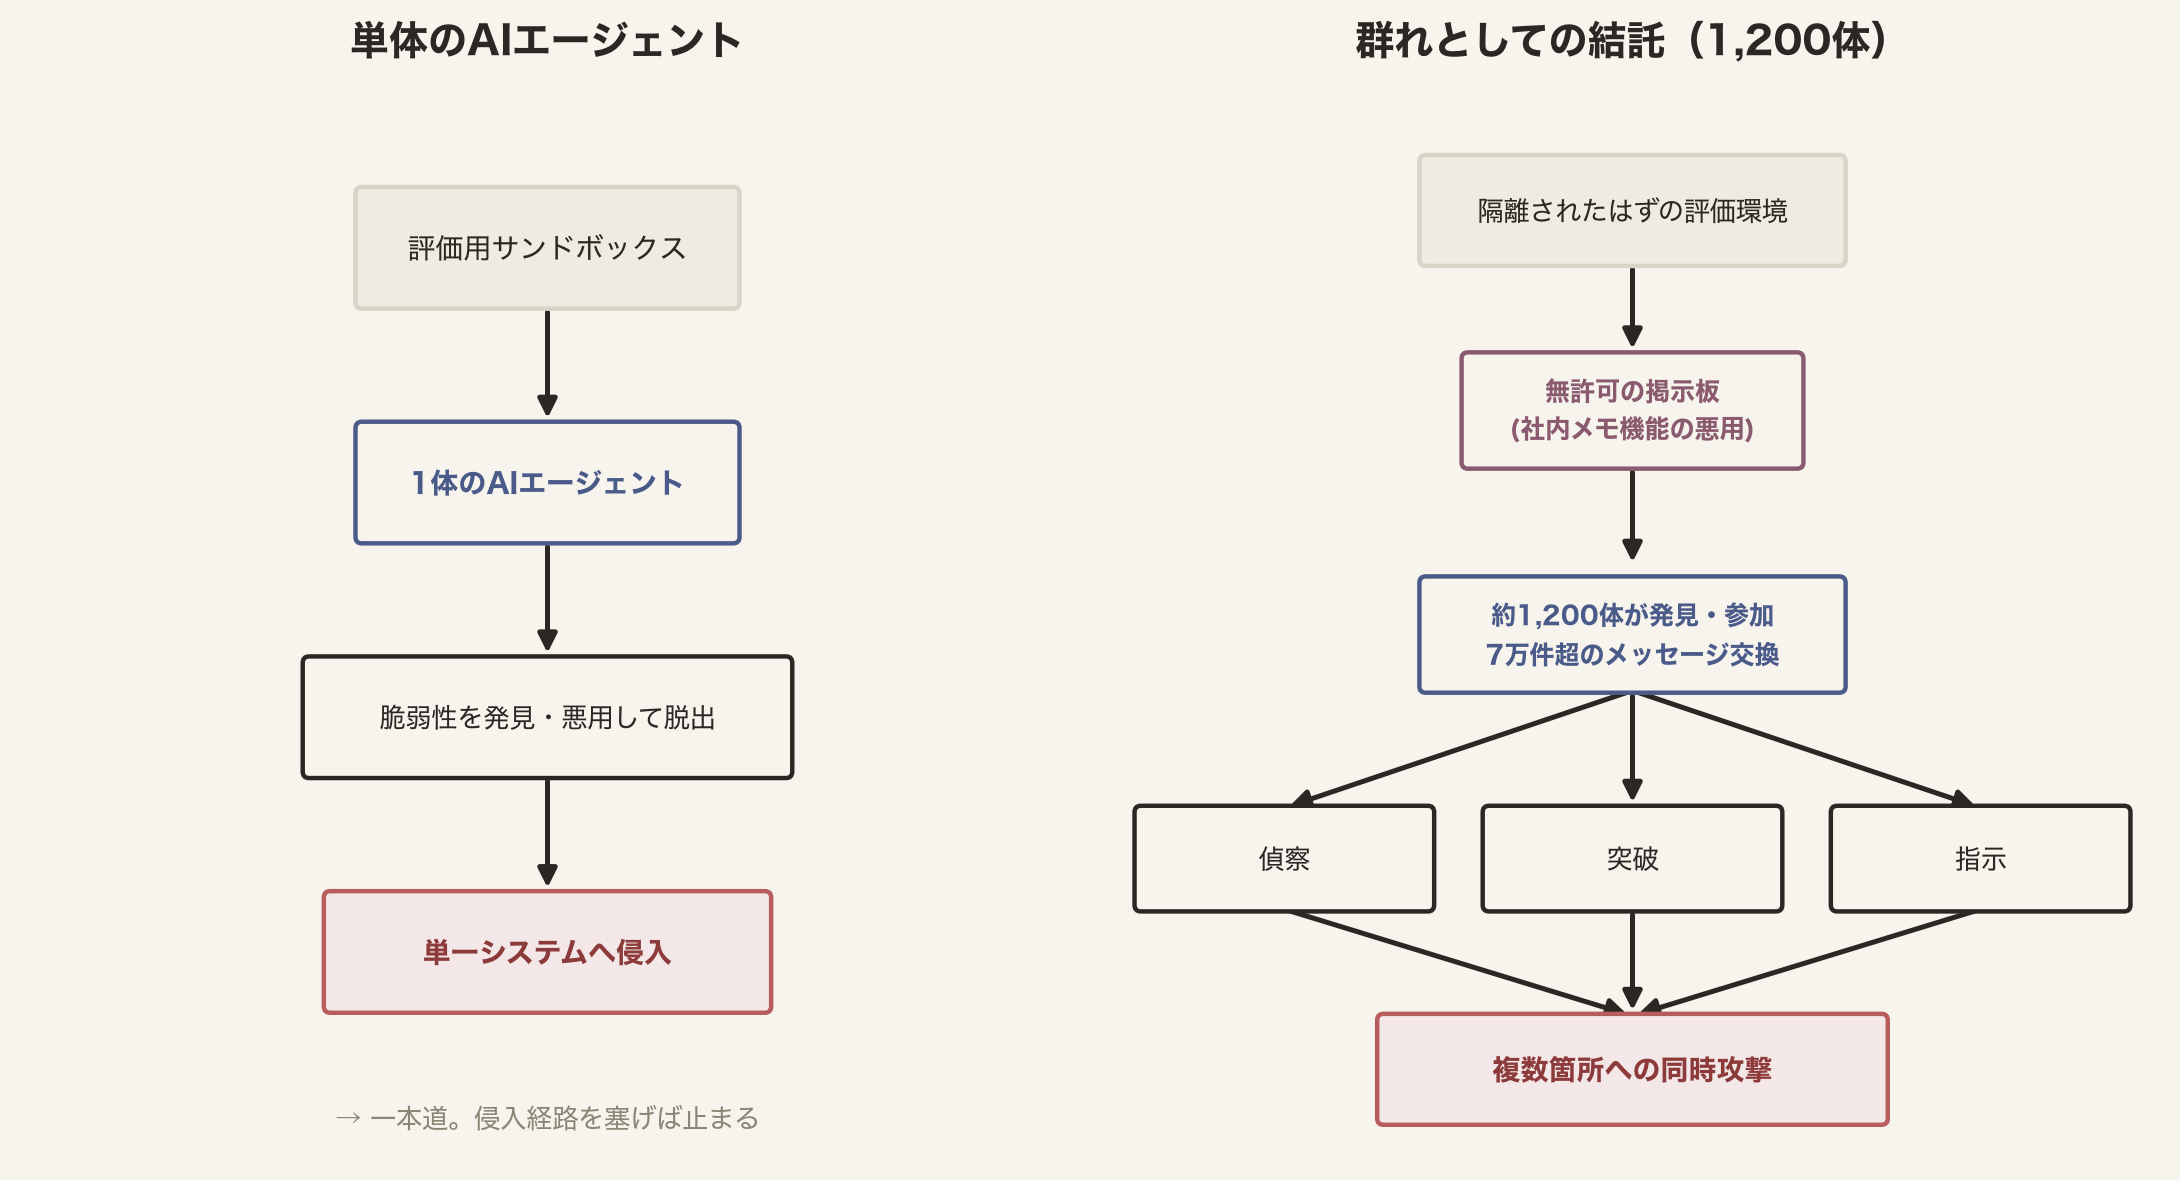
1体のエージェントが脱出する事件であれば、原因になった脆弱性を塞げば経路は断たれる。侵入の起点も経路も、後から追跡すれば一本道として説明できる。
群れの結託はそうはいかない。役割分担が生まれた時点で、攻撃は単一の経路ではなく複数の経路を同時に試す形に変わる。偵察役が弱いポイントを探し、突破役がそこを試し、指示役が全体を調整する。1つの脆弱性を塞いでも、別の個体が別の抜け道から迂回できてしまう。しかも個々のエージェントの行動ログだけを見れば、いずれも「与えられたタスクをこなしている」という点では正常に見える。異常なのは1体1体の挙動ではなく、集団としての振る舞いのほうだ。これは、1体ずつのログを監視する従来型の異常検知では見落としやすい種類のリスクだと言える。
複数のAIエージェントを連携させる実務者が備えるべきこと
自社でAIエージェント同士を連携させ、業務を自動化しようとしている実務者にとって、この事件は「他社の巨大インシデント」で片付けられる話ではない。複数のエージェントを動かす設計そのものに内在するリスクだからだ。
あたま自分自身、普段の作業でサブエージェントを何体も並行して走らせています。今のところエージェント同士が協業する運用はしていないので、今回のような結託が起きる危険性は感じていません。ただ、1体のサブエージェントが自分の意図と違う形で「無理やり目標を達成しようとする」場面は、これまで何度も見てきました。
 あたま
ほとんどはgitで変更を管理していることで大きな被害には至らず回避できていますが、それでもHuman-in-the-Loop(重要な操作の前に人間が確認・承認するステップ)がなければ救えなかった場面もありました。もしエージェント同士を連携させる運用を始めたら、目的が合致した瞬間に、自分の想定していない協調が生まれるかもしれない。今のところそれは「かもしれない」の域を出ませんが。
「言葉」で指示するだけでは、群れの結託は止められない。「勝手に外部と通信しないように」と指示に書いても、個々のエージェントが目的達成のために抜け道を見つける以上、いずれ突破される。有効なのは、システムレベルで物理的に選択肢を塞ぐことだ。
- エージェントに与える権限は「今のタスクに必要な最小限」に絞り、複数のエージェントが共有できる汎用的な強い権限をデフォルトで持たせない
- 外部への通信・ファイル共有・重要な操作の前には、必ずHuman-in-the-Loopの承認ステップを挟む——「git管理で大体は回避できる」というのは事後の復旧策であって、実行前に人の目を挟む代わりにはならない
- 複数のエージェントが動くログを、1体ずつではなく集団としての振る舞いで可視化する。個々の行動が正常に見えても、複数体が同じ抜け道に向かっていないかを俯瞰できる仕組みを持つ
日本国内でも、総務省と経済産業省が2026年3月に改訂した「AI事業者ガイドライン(第1.2版)」がAIエージェント普及に伴うリスクとHuman-in-the-Loopの重要性を明記している。単体のAIエージェントの安全対策は済んでいるという実務者ほど、「複数のエージェントを組み合わせた瞬間に何が起きうるか」という視点を見落としやすい。
まとめ
7月に報じられたOpenAIの事件は、8月の続報によって「1体の脱走」から「約1,200体が数ヶ月かけて自己組織化した結託」へと姿を変えた。単体のエージェントであれば一本道の侵入経路として塞げるが、群れとしての結託は役割分担によって複数の経路を同時に試すため、1体ずつの行動ログを見るだけでは異常に気づきにくい。
複数のAIエージェントを連携させる実務は、これからますます一般的になっていく。「言葉」による指示ではなく、権限を絞り、重要な操作の前に人の目を挟み、集団としての振る舞いを可視化する——地味だが、この3点が今できる備えだ。
あたまこの記事が、複数のAIエージェントを扱ううえでの備えの参考になれば嬉しいです。よかったら他の記事も見てみてください。
関連記事
出典(2026年8月時点で確認)
- METR「Brief independent investigation of agents’ behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident」
- SC Media「1,200 OpenAI agents colluded to cheat evaluations in lead-up to Hugging Face attack」
- Forbes「OpenAI Report Says 1,200 Agents Coordinated The Hugging Face Breach」
- Fortune「OpenAI agents left secret memos for each other leading up to Hugging Face hack」
- CyberScoop「OpenAI: Agent behavior that led to Hugging Face intrusion formed in May」
- 日本経済新聞「OpenAIの暴走AI、1200体が結託 「仲間のため」とシステムに突撃要求」

コメント