
AIエージェントは何をどう「覚えている」のか——記憶アーキテクチャを仕組みから理解する
「このエージェント、前回のやり取りを覚えていてすごい」——そう感心した直後に、別の場面では同じことを何度も聞き直されて拍子抜けした経験はないだろうか。
- 「記憶」が急に第一級のアーキテクチャ要素として語られるようになった背景
- In-Context・Episodic・Semantic・Proceduralという4層の役割分担
- RAGと「エージェントメモリ」は何が違うのか
- 検索型メモリが実際どれくらいトークン効率がよいのか(数値)
- 「覚える」だけでは足りない、という業界の新しい論点
なぜ今「記憶」の話が急に大事になったのか
2025年から2026年にかけて、AIエージェントは「文章を生成するツール」から「実務を自律的に完結させる存在」へと役割を広げてきた。単発の質問に答えるだけなら記憶は要らない。だが、複数日にまたがるタスクを任せたり、ユーザーの好みを踏まえて動いてもらったりするなら、話は別だ。前回何をしたか・何を約束したかを覚えていないエージェントは、任せるたびにゼロから説明し直す必要があり、使いものにならない。
こうした流れの中で、AIエージェントのメモリは独自のベンチマーク・研究文献・比較可能な性能ギャップを持つ、れっきとした技術要素として扱われるようになった。
CoALAの4層で整理する記憶
 あたま
「エージェントのメモリ」とひとくくりに語られがちですが、実装レベルでは性質のまったく違う複数の仕組みが同居しています。どれが何を担っているかを取り違えたまま設計すると、期待通りには動いてくれません。
Princeton大学が2023年に提唱した「CoALA」というフレームワークは、エージェントのメモリを4種類に分類する。この4層構造は2025〜2026年にかけて業界の共通言語になりつつある。
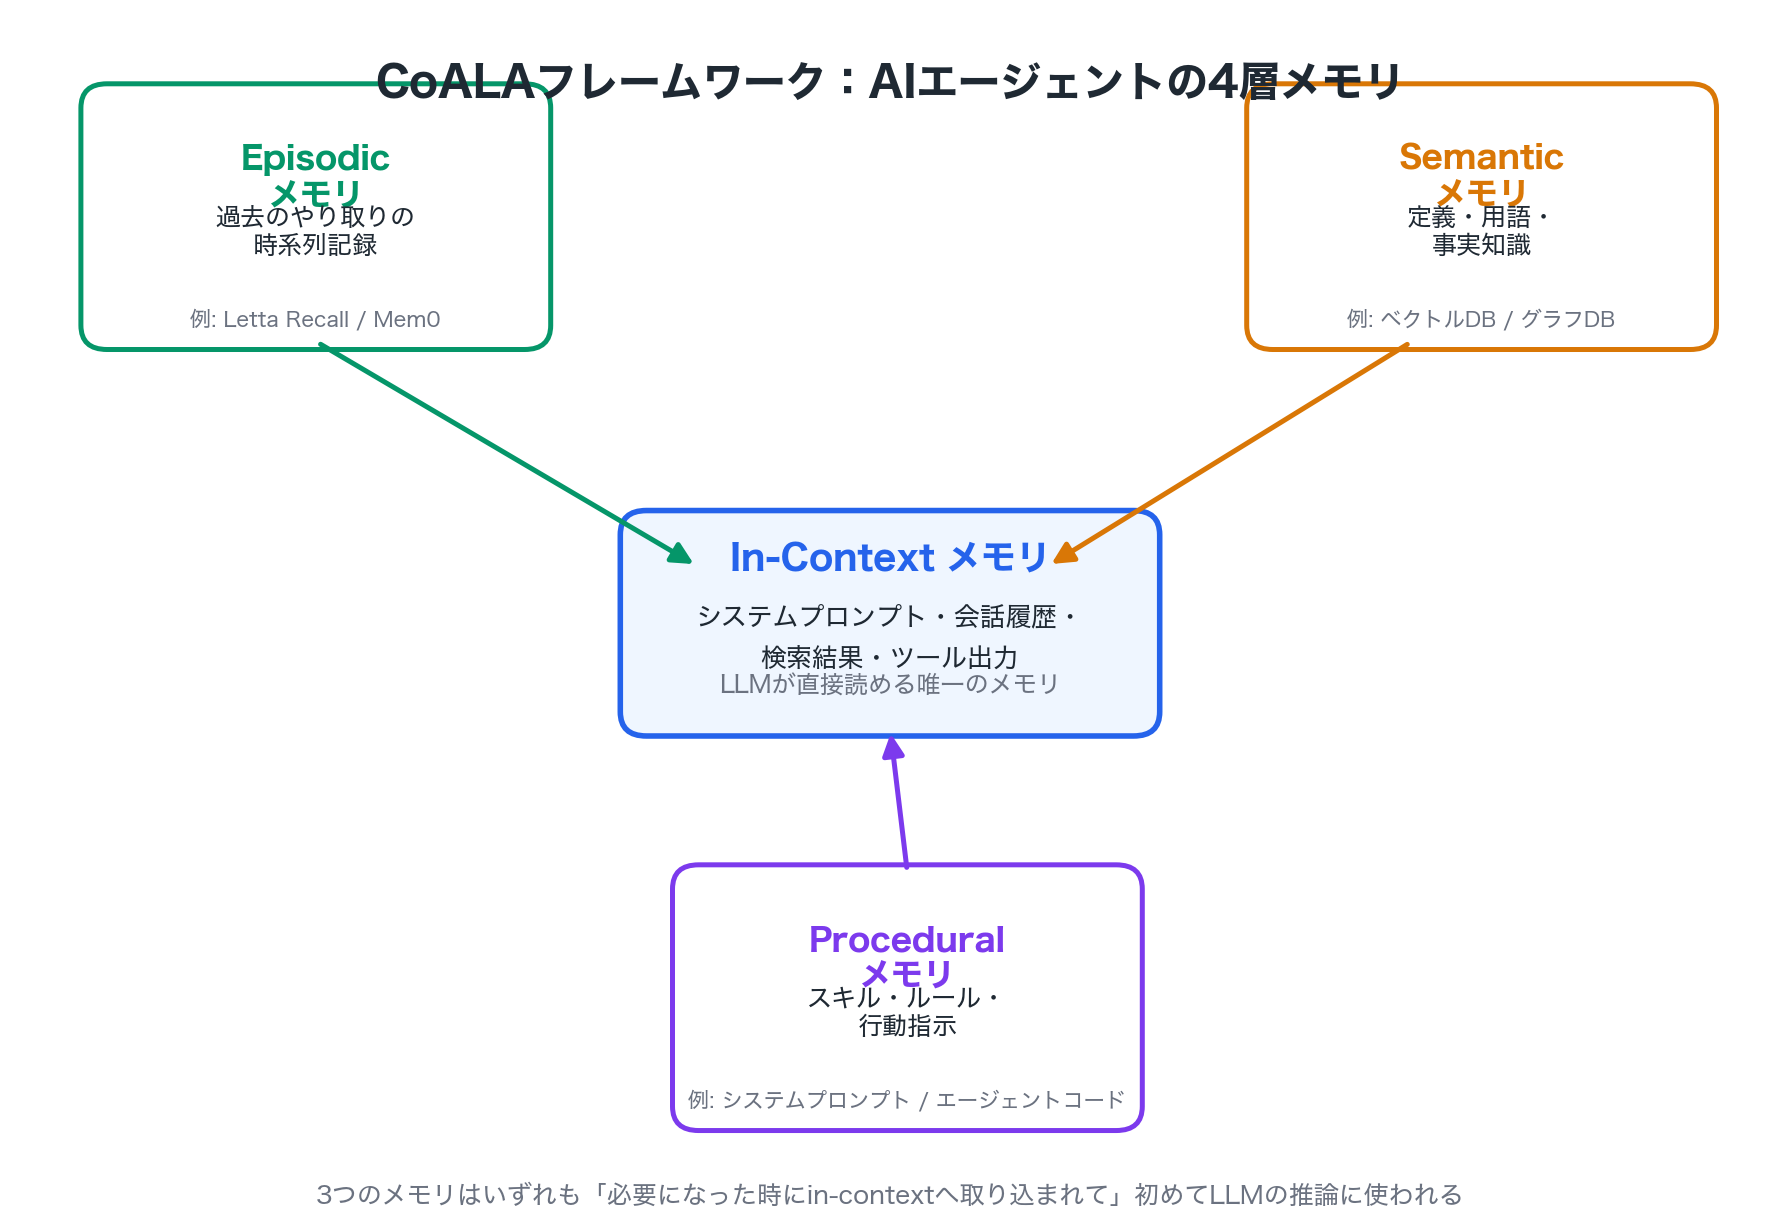
- In-Context(作業)メモリ — 今まさにLLMが読んでいる内容そのもの。システムプロンプト・会話履歴・検索結果・ツール出力から成る。他の3つのメモリは、実際に使われる瞬間には必ずここへ取り込まれる。いわば「LLMが直接読める唯一の窓口」。
- Episodic(エピソード)メモリ — 過去のイベント・やり取りの時系列記録。「何が起きたか」の履歴。Mem0やLettaのRecall Memoryといった実装が該当する。
- Semantic(意味)メモリ — 定義・用語・事実知識。ベクトルDBやグラフDBに保存され、「何が既知か」を担う。
- Procedural(手続き)メモリ — スキル・ルール・行動指示。システムプロンプトやエージェントのコード自体に埋め込まれる、「どう振る舞うべきか」の記憶。
ポイントは、Episodic/Semantic/Proceduralはあくまで「外部倉庫」で、LLM自身がそれを直接読んでいるわけではないという点だ。必要になったタイミングでIn-Contextへ検索・取り込まれ、初めて推論に使われる。「エージェントが覚えている」という言い方は正確には、「必要な記憶を適切なタイミングでコンテキストに呼び戻せている」ことを指している。冒頭の、前回は覚えていたのに次は同じことを聞き返してくる——というあの落差も、たいていはこの引き戻しの失敗として説明がつく。
RAGとエージェントメモリは何が違うのか
ここで混同しやすいのが、RAG(検索拡張生成)との違いだ。RAGは基本的に、あらかじめ用意された静的な外部知識ベースを検索して回答に反映する仕組みである。対してエージェントメモリは、エージェント自身が経験したこと——何を実行したか、何を約束したか、ユーザーが何を確認したか——を自分で書き込み・更新し続ける、動的なシステムという点が異なる。
Semantic層は「一般的にRAGと同じ発想」で作られることが多いが、Episodic層はエージェント自身の行動ログという点でRAGの元々の設計対象(静的文書)とは性質が違う。この違いを踏まえずに「メモリ=RAGを足せば解決」と単純化すると、時間経過とともに増え続ける記録の扱いでつまずきやすい。
数字で見るトレードオフ——mem0 2026ベンチマーク
「検索型のメモリは、全部をコンテキストに詰め込むより本当に効率がいいのか」という疑問に、mem0の2026年レポートは具体的な数値で答えている。
| ベンチマーク | スコア | トークン/クエリ |
|---|---|---|
| LoCoMo | 92.5 | 約6,956 |
| LongMemEval | 94.4 | 約6,787 |
| BEAM(1Mトークン規模) | 64.1 | 約6,719 |
| BEAM(10Mトークン規模) | 48.6 | 約6,914 |
比較対象となるフルコンテキストのベースライン(会話履歴を全部そのまま詰め込む方式)は、クエリあたり25,000トークンを超える。検索型メモリはその4分の1程度のトークンで、同等以上の精度を出している計算になる。特に時間に関する推論(「先週言っていたことは?」のような問い)で+29.6ポイント、複数の情報をまたぐ推論で+23.1ポイントの改善が報告されており、これは「単に古い会話を貯め込む」のではなく「必要な断片を的確に引き出す」設計改善(新規に書き込むだけでUPDATE/DELETEをしない蓄積型アルゴリズムへの変更)によるものだという。
「覚える」だけでは足りない——ガバナンスという視点
記憶を増やし、検索精度さえ上げれば、エージェントはどんどん賢くなっていく——そう思いたくなる。だが2026年6月に公開されたarXiv survey「Always-On Agents」は、この前提に釘を刺す。
このsurveyが扱う「常時稼働するエージェント(always-on agent)」の状態は、検索可能な記憶だけにとどまらない。タスクの進捗を記録した台帳、権限や認証情報、交わした約束事、来歴・監査記録、外部システムに実際にコミット済みの効果——これらすべてが、将来の振る舞いを左右する「状態」として扱われるべきだと指摘する。
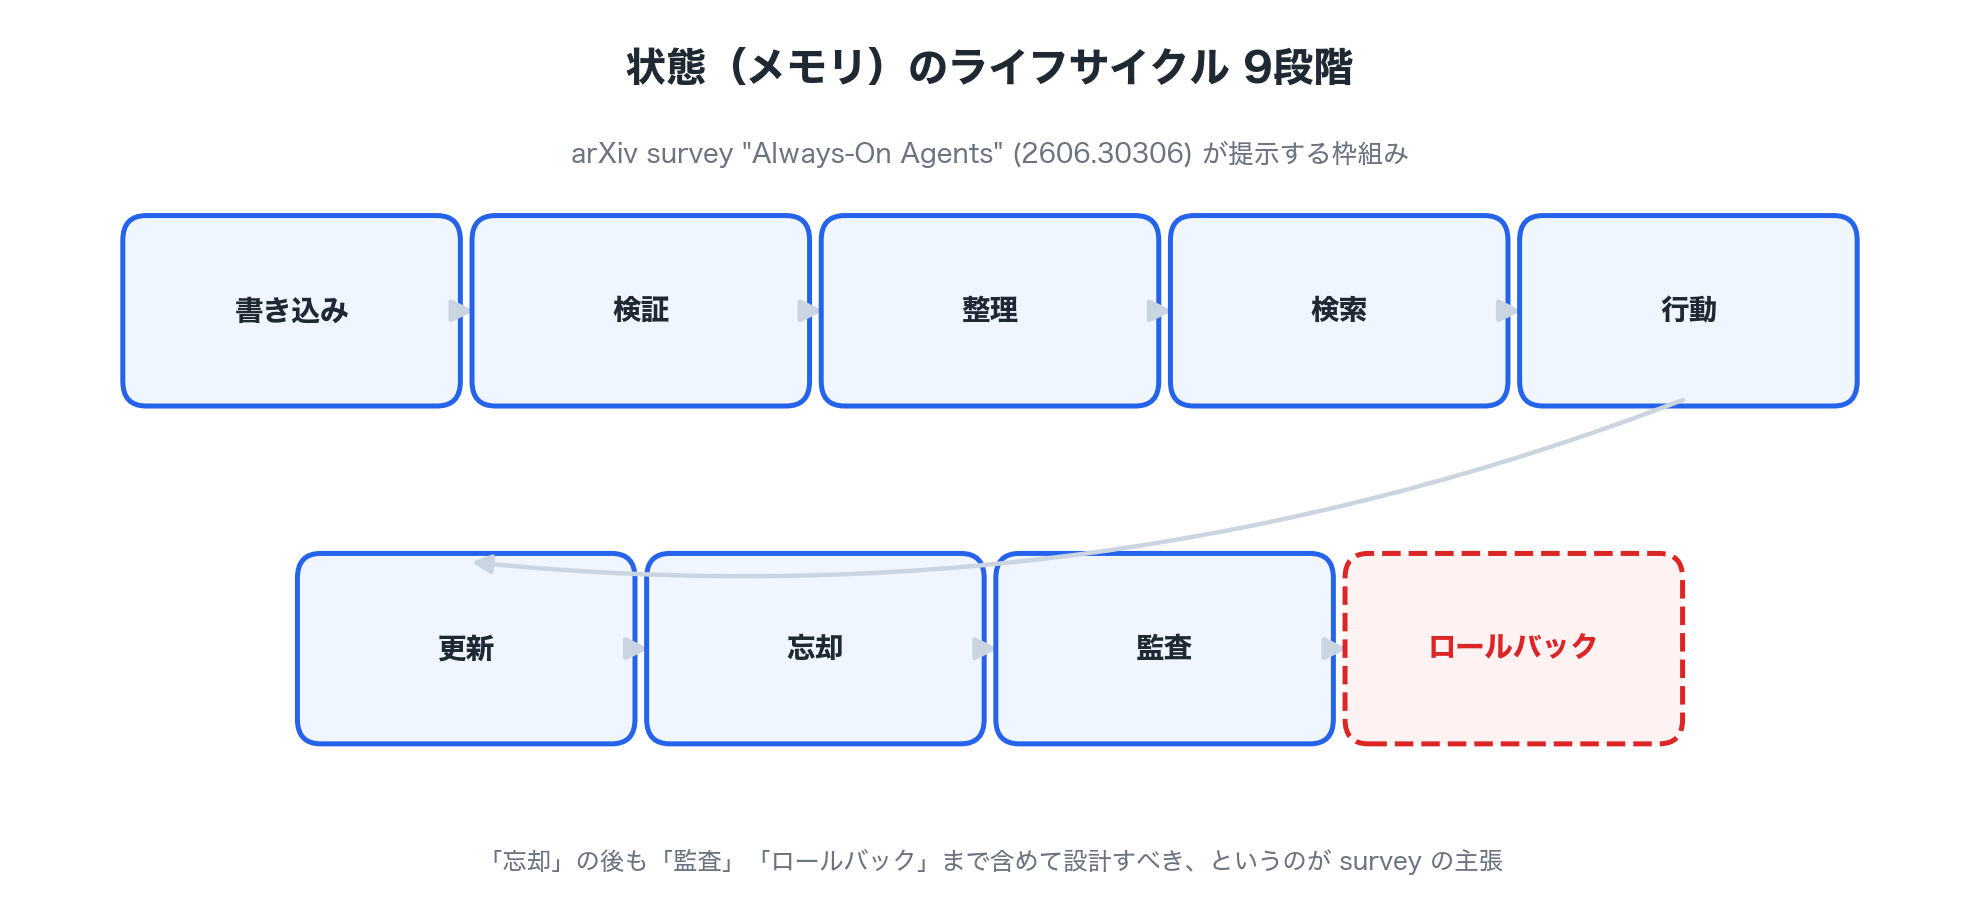
surveyは435本の文献をコーディングして分析した結果、業界の研究の大半が「蓄積・検索」のフェーズに偏っており、統治(governance)・回復・忘却のフェーズへの言及が薄いと指摘している。書き込んだ記憶を誰がどう変更してよいか、間違って書き込まれた記憶をどう取り消すか——この設計を後回しにしたまま「覚えられるエージェント」だけを追い求めると、後になって「なぜこの記憶が残っているのか説明できない」という状況に陥りやすい。
「記憶を増やす」設計と「記憶を統治する」設計は別物だ。業務でエージェントに記憶を持たせる際は、何を覚えさせるかと同じくらい、いつ・誰の判断で忘れさせる/訂正するかを先に決めておくとよい。
実務でどう使い分けるか
あたま全部を書き留めておけば、あとで困ることはない。研究現場で生成AI活用を進める中で、実験データ・議論の経緯・解釈まで、ほぼすべての実験関連情報をLLM wiki(RAGベースの知識ベース)に蓄積してきたのも、最初はそういう発想からでした。
これはSemantic層の実践例そのものだ。ただし、そう単純にはいかなかった。情報量が増えるにつれて、検索精度そのものが劣化していくという壁にぶつかったのである。全部を記憶させておけば安心、というわけではない——記憶が増えるほど、その中から「本当に必要な断片」を的確に引き当てる検索側の設計のほうが重い課題になる。単純な類似検索だけに頼らず、RAGの検索能力自体を底上げする仕組み作りに取り組み直したのは、この壁を実際に踏んでからだ。奇しくもmem0も2026年のアルゴリズム更新で、「単純な蓄積」から「マルチシグナル検索(意味的類似度・キーワード・エンティティマッチの並列実行)」へ同じ方向に舵を切っている。
実務での使い分けの目安はシンプルだ。
- 今の会話だけで完結する短い作業指示 → In-Contextに任せる
- 繰り返し参照する事実・ルール → Semantic/Proceduralに切り出す
- 進行中のタスクの経過 → Episodicに記録する
個人のPKM(Personal Knowledge Management)にAIエージェントを組み込む場合も、この4層の役割分担を意識すると、どのツール・どの設定が何を担っているか見通しやすくなる。
まとめ
AIエージェントが「覚えている」という言い方の中身は、実際にはIn-Context・Episodic・Semantic・Proceduralという性質の異なる4層が連携した結果にすぎない。どの層が何を担い、どう検索され、どう統治されるかを分けて理解しておくと、「なぜこのエージェントは覚えていて、あのエージェントは覚えていないのか」を仕組みのレベルで説明できるようになる。記憶を増やすことと、記憶を統治することは別の設計課題だという視点も、業務で使う際にはぜひ持っておきたい。
あたまこの記事が役に立てば嬉しいです。よかったら他の記事も見てみてくださいね。
関連記事

コメント