
複数のAIサービスをどう連携させるか?情報をNotionに集約した理由
ChatGPTで作った資料の続きを、翌日Claudeで進めようとしたら、また一から説明することになった。そんな経験はありませんか?
- 複数の生成AIを使うと情報がバラバラになる本当の理由
- 「セッションの記憶が消える」問題と「LLM間の情報格差」の違い
- 情報格納のハブに何を選ぶかの判断基準
- Notionを選んだ具体的な決め手
なぜ「複数の生成AIを使う」と情報がバラバラになるのか
2026年7月から8月にかけて、あるお客様のもとで、生成AIを使った資料作成を支援するプロジェクトに1ヶ月ほど関わりました。対象は13回にわたる長期の講義シリーズです。1回の講義につき構成案、スライド、対訳表、参考文献リストといった複数の成果物があり、それを複数の作業者が、ChatGPTとClaudeを併用しながら作っていく体制でした。
最初にぶつかったのは、技術的な難易度の高さではなく、もっと地味な問題でした。
 あたま
「昨日ChatGPTと詰めた内容を、今日Claudeに伝えるだけなのに、なぜかうまく伝わらない」。最初はそう感じていました。
やっていたことは単純です。片方のAIとの対話で決まった内容を資料に書き出し、それをコピペしてもう片方に渡す。ところがチャットセッションが変わるたびに、この運用は最初からやり直しになります。コピペした内容だけでは前提知識が微妙に足りず、「なぜその判断になったのか」を毎回また説明し直すループに陥っていました。13回分の講義×複数の成果物×複数の作業者という規模になると、このループのコストは無視できない大きさになります。
コピペ運用は、1人、1つのAI、短期の作業なら破綻しません。壊れるのは「複数人×複数AI×長期」の組み合わせが揃ったときです。この記事のケースは、まさにその3条件が同時に揃っていました。
「記憶の断絶」ではなく「LLM間の情報格差」
この問題を整理していくと、実は2つの異なる断絶が重なっていることが見えてきます。
1つ目は、同じAIの中でもチャットセッションが変わると文脈が消えるという断絶。これは多くの人が経験しているはずです。
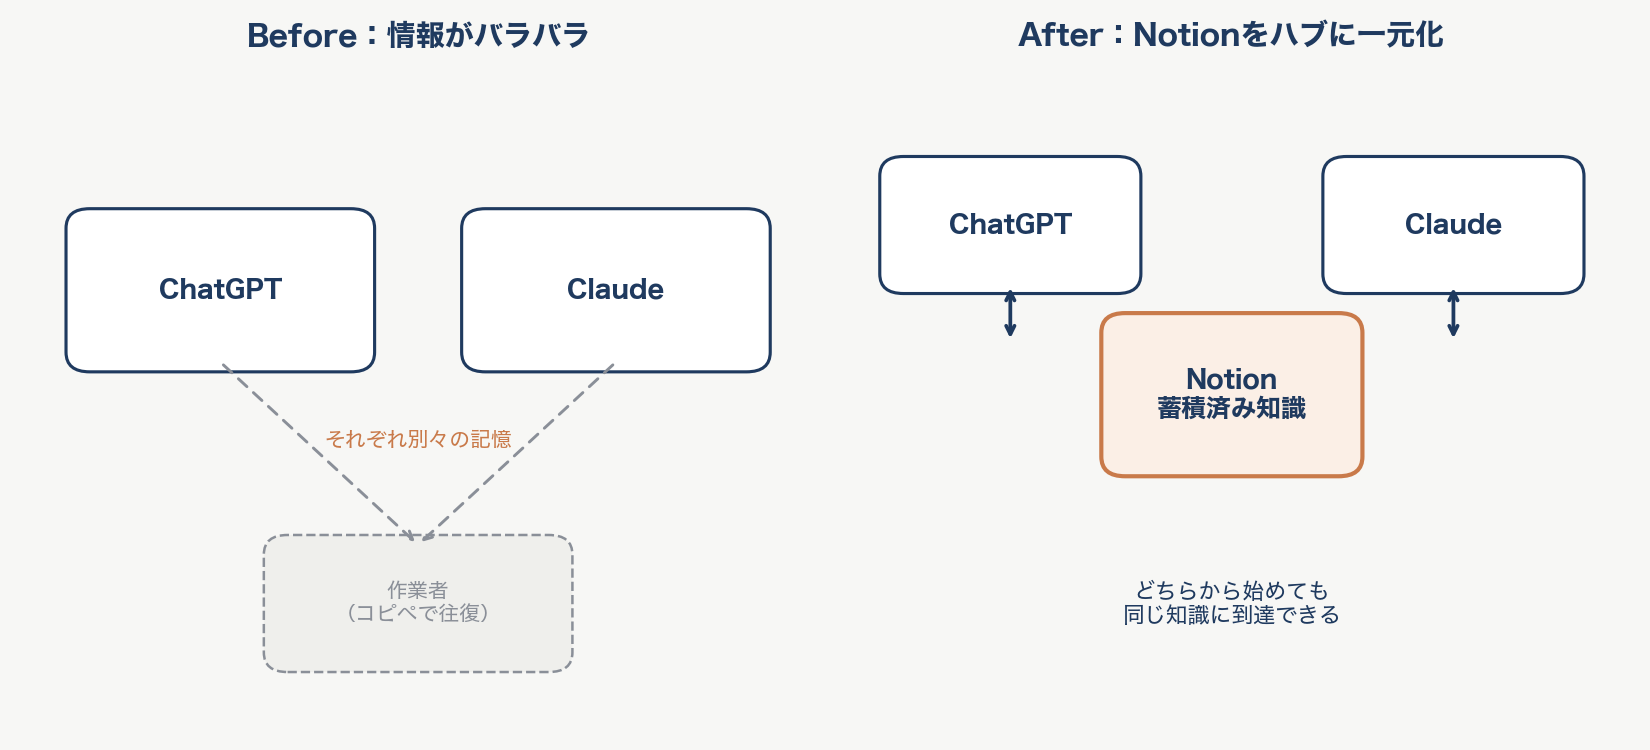
2つ目が、より見落とされがちなLLM間の情報格差です。ChatGPTとClaudeはそれぞれ別の記憶を持っていて、どちらで会話を始めたかによって、たどり着ける知識が変わってしまう。1つ目の断絶を解決する工夫(例えば長いプロンプトで要約を渡す)を積み重ねても、この2つ目の格差は残り続けます。
目指すべきなのは「情報の保管庫を作ること」ではなく、ChatGPTとClaudeのどちらから会話を始めても、同じ蓄積済みの知識にたどり着ける状態を作ることです。この一文を判断基準に据えると、ツール選びで何を優先すべきかが自然と絞られてきます。
保管庫という発想だと、どこかにファイルを溜めておけばよいという話になりがちです。でも実際に困っていたのは「溜め方」ではなく「複数のAIから対等にアクセスできるかどうか」でした。この視点の転換が、次の情報ハブ選びの判断基準に直結します。
情報格納のハブに何を選ぶか
「LLM間の情報格差」を解消するという視点に立つと、情報格納のハブに求める条件は自然と3つに絞られました。
- 複数の作業者が同時に情報を閲覧でき、検索もできること
- 管理者(お客様側の担当者)がすでに使い慣れていて、運用を任せられること
- 複数の生成AIサービスから、公式な経路で読み書きできること
3つ目が実は一番の決め手でした。Google DocsやConfluence、Slackも候補には挙がりましたが、いずれも「人間が閲覧する場所」としては優れていても、複数の生成AIサービスから対等に読み書きできる公式な経路を備えているわけではありません。ChatGPTとClaude双方が公式コネクタで接続できる、という一点だけで候補は絞り込まれていきました。
Notionを選んだ決め手は、複数作業者からの閲覧性と検索性の高さ、お客様側の管理者がすでに使い慣れていたこと、そしてChatGPTとClaude双方から公式な経路でアクセスできることの3点が揃っていたためです。データの持ち運びやすさやコストで選んだわけではありません。
全部のAIを「対等」に扱わなかった
情報ハブを一本化したあと、もう一つ判断が必要になったことがあります。それは「連携するすべての生成AIを同じように扱うべきか」という問題でした。
このプロジェクトでは、ChatGPTとClaudeはNotionに対してフルに読み書きできる一方、Geminiだけは入力側専用という非対称な役割に位置づけました。理由は単純で、Geminiには当時、蓄積した情報を検索して取り出す公式な経路がなかったからです。書き込みだけを無理に通しても、「書けるが読めない」中途半端な参加者が増えるだけで、目指していた状態には近づきません。
あたまむしろGeminiには、資料の要約や構造化という得意な仕事を任せ、Notionへの良質な入力を供給してもらう役割に振り切りました。「全部のツールを同じように使えるようにしよう」と欲張らなかったのがポイントです。
対応状況が非対称なツールを、無理に均そうとするコストは、非対称なままそれぞれの得意分野に役割を割り振るコストより、たいてい高くつきます。この考え方は、生成AIを複数併用する場面全般に応用できる判断軸だと感じています。
まとめ
複数の生成AIを併用するプロジェクトで最初にぶつかったのは、「セッションの記憶が消える」という表面的な問題の奥にある、「LLM間の情報格差」という本質的な課題でした。目指す状態を「保管庫を作ること」ではなく「どちらのAIから始めても同じ知識にたどり着けること」と定義し直したことで、情報ハブに求める条件が絞り込まれ、Notionという選択にたどり着きました。
ただし、情報を一箇所に集めただけでは終わりません。集めた情報を「人にも優しく」検索でき、可視化もできるデータベースとして設計する工程や、当初お客様の要望で別のAIサービスを前提に組んでいた設計を途中で転換した判断など、まだ書くべき話が残っています。それはこのシリーズの続編で紹介します。
関連記事

コメント