
無料で使えるローカル埋め込みモデルでRAGを構築する|日本語対応モデル比較
ローカルでRAGを組みたいけれど、埋め込みモデルは結局どれを選べばいいのかで手が止まっていないだろうか。
「社内文書やナレッジベースをAIで検索できるようにしたい。ただしOpenAIのAPIにデータを送るのは避けたいし、コストもかけたくない」。こう考えたとき、真っ先にぶつかる壁が埋め込みモデル選びだ。Ollamaで検索すればモデルは山ほど出てくるが、どれが日本語に強いのか、無料枠のクラウドAPIとどれくらい精度差があるのか、比較情報は驚くほど少ない。
結論から言うと、日本語コンテンツが中心ならruri-v3(名古屋大学cl-nagoya開発、Apache-2.0)が2026年8月時点の第一候補になる。310Mパラメータという小さなモデルでありながら、精度最上位のクラウドAPIにわずかな差まで迫るという実測結果が出ている。
「無料」には2つの種類がある
RAGにおける埋め込みモデルの役割(テキストをベクトルに変換し、意味の近さで検索する仕組み)については、以下の記事で仕組みから解説している。
ここから先は、その埋め込みをどのモデルで作るかという選択の話になる。まず押さえておきたいのは、「無料」には性質の異なる2つの選択肢があるという点だ。
- 完全ローカルで動くオープンソースモデル:Ollamaやsentence-transformersで自分のマシン上に実行する。データが外部に一切出ない、実行コストもゼロ
- 無料枠のあるクラウドAPI:ローカルではないがAPIの利用コストはゼロ。精度は高いが、データは外部送信され、レイテンシもローカルより遅い
プライバシー要件やレイテンシを重視するなら前者、精度を最優先するなら後者という住み分けになる。以下、それぞれ具体的に見ていく。
完全ローカルで動く埋め込みモデルの選択肢
Ollama対応の埋め込みモデルには実用レベルのオープンソース選択肢が揃っている。ライセンスとパラメータ数、日本語対応の有無を軸に整理すると次のようになる。
| モデル | パラメータ | ライセンス | 日本語 | 備考 |
|---|---|---|---|---|
| all-MiniLM-L6-v2 | 22.7M | Apache-2.0 | 弱い | 最軽量(約0.1GB)、CPUのみで動作。プロトタイピング向け |
| nomic-embed-text-v1.5 | 137M | Apache-2.0 | 弱い | Ollama一発pull(約0.3GB)で使える最も手軽な入口 |
| bge-m3 | 568M | MIT | 対応(100言語以上) | 密+疎ハイブリッド検索、8K文脈。多言語RAGの事実上の標準 |
| Qwen3-Embedding-0.6B/8B | 0.6B/8B | Apache-2.0 | 対応 | 小型で最高品質帯〜トップ性能帯。8Bは要GPU(Q4量子化で約5GB) |
| ruri-v3(cl-nagoya) | 30M〜310M | Apache-2.0 | 特化 | ModernBERT-Ja採用。日本語RAGでは最有力候補 |
NV-Embed-v2やjina-embeddings-v3は精度こそ高いが、ライセンスがCC-BY-NC-4.0で商用利用不可という落とし穴がある。個人検証だけなら問題ないが、将来アフィリエイトや業務利用に転用する可能性が少しでもあるなら、Apache-2.0やMITのモデル(ruri-v3、bge-m3、Qwen3-Embedding系、nomic-embed-text)を選んでおくのが安全だ。
日本語RAGならruri-v3が第一候補な理由
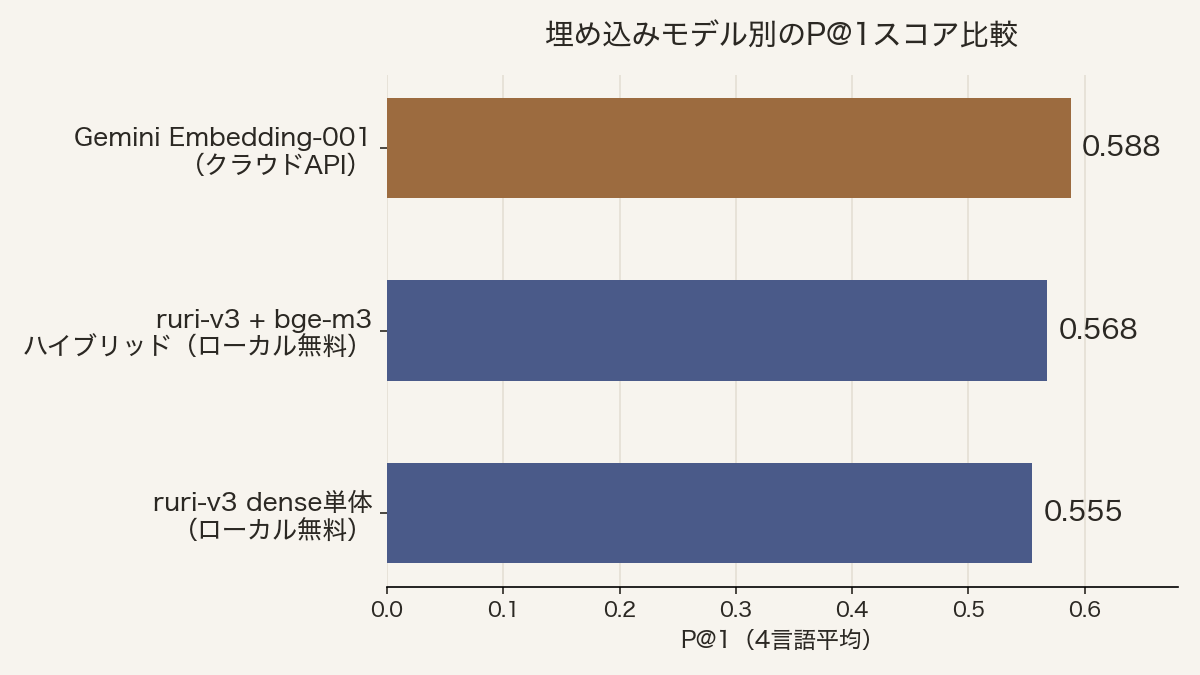
なぜruri-v3を推すのか。根拠は、日本語RAGを4言語2000問の検索タスクで実測比較したベンチマークにある。
| モデル | P@1 | P@3 | MRR |
|---|---|---|---|
| Gemini Embedding-001(クラウドAPI) | 0.588 | 0.831 | 0.724 |
| ruri-v3 + bge-m3ハイブリッド(ローカル) | 0.568 | 0.759 | 0.688 |
| ruri-v3 dense単体(ローカル) | 0.555 | 0.797 | 0.694 |
精度最上位はやはりGemini Embedding-001だが、ruri-v3はローカルで動く無料モデルというハンデを背負いながら、P@1でわずか0.033差まで迫っている。しかも上位3件までの精度(P@3)では、ruri-v3のdense単体(0.797)がGeminiのハイブリッド構成を上回る場面もある。ハイブリッド検索は候補を広く拾うP@10では有利になる一方、上位数件の精度を求める用途ではdense単体の方が良いケースもある、というのが実測から見える示唆だ。
レイテンシの差も無視できない。ローカルモデルは0.1〜0.2msで応答するのに対し、クラウドAPIは324〜380msかかる。桁で違う。
 あたま
310Mパラメータという小ささでこの精度が出るのは正直意外でした。日本語特化で鍛えたモデルは、汎用の多言語モデルより「量より質」で戦えるということなんだと思います。
埋め込み単体での限界とリランキングの必要性
この数値は、実際に自分のナレッジベースで運用したときの感触と一致するのだろうか。
筆者は自分の研究記録を蓄積しているknowledge-wiki(Obsidianベースの個人ナレッジベース)の検索に、Ollama経由でnomic-embed-textやbge-m3といった標準的な埋め込みモデルを使ってきた。結果はそれなりに良い。意味的に近いページはちゃんと上位に出てくる。ただし運用を続けるうちに、埋め込みによる類似度検索だけでは、上位に出てきた候補を「これでいいか」と鵜呑みにできない場面が出てくることに気づいた。似ている文書は拾えても、その中で本当に今の質問に対して的確なのはどれか、という一段細かい絞り込みが甘くなる感覚だ。
これは前述のZennベンチマークで、ハイブリッド検索がP@10(広く拾う)では有利でもP@3(上位を絞り込む)ではdense単体に負ける場面があったのと地続きの話に思える。埋め込みによる意味検索は「候補を広く集める」フェーズには強いが、そこから「本当に的確な上位数件」まで絞り込むには、もう一段の再評価(リランキング)が要る、というのが実際に運用してみた実感だ。
埋め込みモデル単体の精度比較で満足せず、「埋め込みで広く候補を集めてから、リランカーで絞り込む」という2段構成を前提に設計するのが実務的な落としどころになる。ruri-v3にも同じ名古屋大学チームが公開しているruri-v3-rerankerが対応しており、無料・ローカルのまま2段構成を組める。
無料APIという選択肢との使い分け
完全ローカルにこだわらないなら、Gemini Embedding-001も有力な選択肢になる。無料枠は1分あたり1,000万トークンと寛大で、精度もベンチマーク上は最上位だ。
判断基準はシンプルにまとめられる。
- データを外部に一切出したくない、レイテンシも最小化したい:ruri-v3(日本語中心)またはbge-m3(多言語やコード検索も含む)
- 精度を最優先し、データ送信もAPIキー管理も許容できる:Gemini Embedding-001(無料枠内で運用)
社外に出せないデータを扱う事情がある場合は、埋め込みモデルだけでなくLLM本体も含めてローカルで完結させる構成の検討が必要になる。その判断軸は以下の記事にまとめてある。
まとめ
無料でローカルのRAGを組むなら、埋め込みモデルの選択肢は思っているより豊富にある。日本語中心ならruri-v3、多言語やコード検索も視野に入れるならbge-m3、精度を最優先するならGemini Embedding-001の無料枠、という3択で大きく外すことはない。ライセンス(CC-BY-NCモデルの商用不可)だけは事前に確認しておきたい。
一方で、埋め込みモデルの精度比較だけを見て満足すると、実運用でつまずく。候補を広く集める埋め込み検索と、そこから絞り込むリランキングは別の仕事であり、両方揃えて初めて「使える」検索になる。ベンチマークの数字と、実際に自分のデータで動かしたときの体感は、必ずしも一致しない。
さらに検索精度を高めたい場合、GraphRAGやAgentic RAGといった発展形も選択肢に入ってくる。次の記事ではその2つの違いを整理している。
関連記事
出典(2026年8月時点で確認)
- Best Local Embedding Models for RAG (2026): Self-Hosted & Ollama-Ready(d-central.tech)
- 【2026年版】日本語RAGのEmbeddingモデル、結局どれが最強なのか?6構成で2000問ベンチマークした(Zenn)
- 実は進化している!ローカルで動くembeddingモデルたち(Zenn)
- cl-nagoya/ruri-v3-310m(Hugging Face)
- Gemini Embedding APIの無料枠については、Google AI Studioの公表値(2026年8月時点)を参照

コメント