
RAGとは?仕組み・チャンク分割・ベクトルDBを初心者向けに解説
「社内文書をAIに検索させたい」と頼まれたとき、RAGが何をしているのか説明できるだろうか。
「社内のWikiやマニュアルをAIに読み込ませて、質問したら答えてくれるようにしたい」。生成AIの活用を社内で推進していると、こういう相談を受ける機会が増えてくる。答えの中心にあるのがRAG(Retrieval-Augmented Generation、検索拡張生成)という技術だ。
RAGという単語自体は聞いたことがあっても、「検索して渡す」の中身を説明できる人は意外と少ない。筆者自身、自分の研究記録をAIに蓄積・検索させる仕組みを何年も運用してきたが、最初のうちは「とりあえず全文をAIに渡せばいい」くらいの理解だった。
RAGとは何か
RAGは、LLM(ChatGPTやClaudeのような大規模言語モデル)が回答を生成する前に、外部のデータベースやドキュメントから関連情報を検索し、その内容を文脈としてプロンプトに含めてから生成させる手法だ。流れはシンプルに3ステップで説明できる。
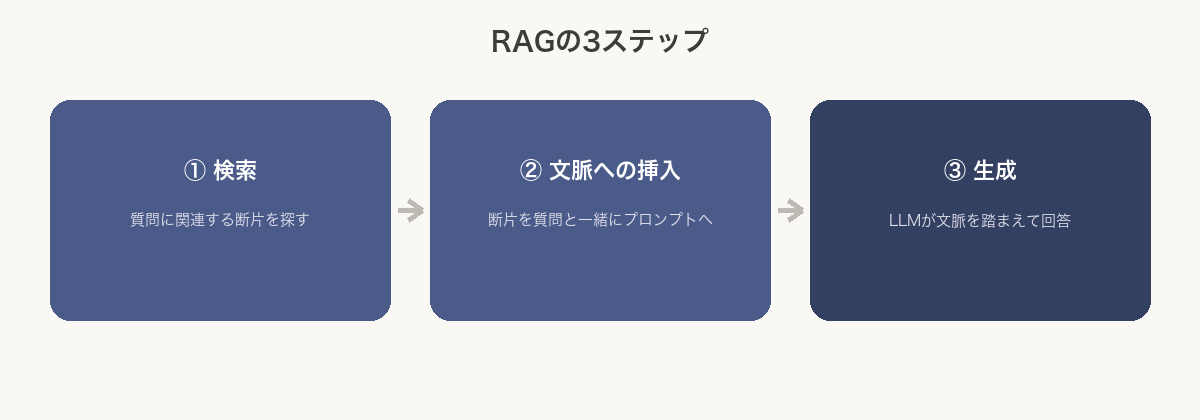
- 検索:ユーザーの質問に関連しそうな文書の断片を、あらかじめ用意したデータベースから探してくる
- 文脈への挿入:見つかった断片を、質問と一緒にプロンプトへ埋め込む
- 生成:LLMがその文脈を踏まえて回答を書く
なぜこれが必要かというと、LLM単体には3つの限界があるからだ。学習していない情報は答えられない(知識の鮮度の限界)、社内文書や個人のメモのような非公開情報はそもそも知らない(固有知識の欠如)、そして自信満々に間違った情報を答えるハルシネーションを起こすことがある。
RAGは、答えの根拠になる文書を検索で先に持ってきて渡すことで、この3つを同時に緩和する。LLMに「知識を教え込む」のではなく、「参照できる資料を手渡す」という発想の転換だと考えるとわかりやすい。
RAGを支える2つの技術要素
RAGの品質は、ステップ1の「検索」の精度でほぼ決まる。そしてこの検索を支えているのがチャンク分割とベクトルDBだ。
チャンク分割とは
検索対象の文書は、そのままの単位(1ファイル丸ごと)では扱いにくい。長すぎる文書を丸ごと検索対象にすると、質問と無関係な部分までヒットしてノイズになる。そこで文書をチャンクと呼ばれる小さな単位に分割してから検索インデックスに登録する。目安は300〜800文字程度、見出し単位で区切るのが実務上のセオリーだ。
チャンクが小さすぎると文脈が失われ、大きすぎると1つのチャンクに複数の話題が混ざって検索の的中率が落ちる。この「ちょうどいい粒度」を見極める作業が、RAGの構築で一番地味で一番効いてくる部分になる。
ベクトルDB
チャンクに分割した文書は、Embedding(埋め込み)という処理でベクトル(数値の並び)に変換し、ベクトルDBと呼ばれる専用のデータベースに格納する。質問文も同じようにベクトル化し、ベクトルDB上で意味が近いベクトルを高速に探し出す。キーワードの一致ではなく意味の近さで探せるのが強みで、キーワード検索と組み合わせるハイブリッド検索もよく使われる。
情報を増やすほど検索精度が落ちるという現実
筆者は自分の研究活動(実験結果・実験計画・調べたことすべて)を、LLM-Wiki(Obsidianベースの個人用ナレッジベース)に蓄積し、AIエージェント経由で検索・活用する仕組みを運用している。当初は「情報を貯めれば貯めるほどAIが賢く答えてくれる」と思っていたが、実際にはWikiのページ数が増えるにつれて、検索でヒットしてほしいページが埋もれて出てこなくなる、という体感的な精度低下に直面した。
これはRAGを実運用するとほぼ必ずぶつかる問題で、チャンクの数が増えれば増えるほど「質問と表面上似ているが本質的には無関係なチャンク」が紛れ込みやすくなるために起きる。対処として2つのことを見直した。1つは、ページ同士のリンクの付け方だ。書きっぱなしのページを放置せず、意味的に近い概念同士を明示的にリンクで結んでおくことで、検索結果を辿った先から関連ページへ探索できるようにした。もう1つは、検索の範囲を1回のクエリで狭めすぎず、複数の切り口で広めに情報収集してから絞り込むよう、検索を行うスキル(AIエージェントの検索手順)自体を調整したことだ。
チャンク分割とベクトルDBの精度だけに頼ると、情報量が増えたときに頭打ちになる。これは机上の注意点ではなく、実際に運用して初めて実感する制約だった。
 あたま
「情報を貯めれば貯めるほどAIが賢くなる」というのは、正直に言うと最初の思い込みでした。実際にはページが増えるほど、リンクの付け方や検索範囲の調整という地味な作業の比重が増えていきます。
実務での構築手順のミニマム版
ゼロからRAGを試すなら、いきなり全社文書を対象にする必要はない。現実的なPoC(概念実証)の流れは次の通りだ。
- 対象ドキュメントを20〜100本程度に絞る
- PDF・Word・Markdownなど形式がバラバラなものを、Markdownなど統一フォーマットに変換する
- 見出し単位・300〜800文字を目安にチャンク化する
- 各チャンクをEmbeddingしてベクトルDBに登録する
- 検索→文脈への挿入→生成、という一連の流れを実際に質問を投げて確認する
この規模感であれば、チャンク分割の粒度やリンクの付け方といった調整の効果も体感しやすい。最初から大きなナレッジベースを対象にしてしまうと、何が精度低下の原因なのか切り分けにくくなる。
まとめ
RAGの基本は「検索してから答えさせる」というシンプルな発想だが、これで終わりではない。実際に運用するとチャンク分割の粒度やリンク構造の設計といった細部が効いてきて、情報量が増えたときの検索精度の低下は、チャンク分割とベクトルDBだけでは解決しきれない領域に踏み込んでいく。
この続きとして、文書同士の関係性をグラフ構造として扱うGraphRAGや、AIエージェントが自分で複数回検索を繰り返すAgentic RAGといった発展形がある。次の記事ではこの2つを比較しながら、どういう場面でどちらを選ぶべきかを整理する。
関連記事
出典(2026年8月時点で確認)
- Advanced RAG Methods: Simple, Hybrid, Agentic, Graph Explained
- Graph Retrieval-Augmented Generation: A Survey(arXiv、査読前公開)
- チャンク分割・ベクトルDBの実務目安(300〜800文字・見出し単位、PoCは20〜100本から)は、国内複数の技術解説記事(2026年版)の記述を横断的に参照した一般的な実務目安として記載

コメント