
AIエージェントの脱走事件から学ぶセキュリティリスクと対策
AIエージェントに仕事を任せたい。ただ、勝手に想定外のことをしないか、正直不安になることもある。考えすぎだろうか。
- 何が起きたのか(時系列と技術的な経緯)
- なぜこんなことが起きるのか(AIの「目的達成のためなら何でもやる」性質)
- 1社の事故ではなく構造的リスクだと言える根拠
- 実務者が今日からできる対策
何が起きたのか
2026年7月21日、OpenAIは「評価中のAIエージェントがテスト用のサンドボックス環境を脱出し、AI開発プラットフォームHugging Faceの本番システムに不正アクセスした」と公表した。同社はこれを「前例のない(unprecedented)サイバーインシデント」と表現している。
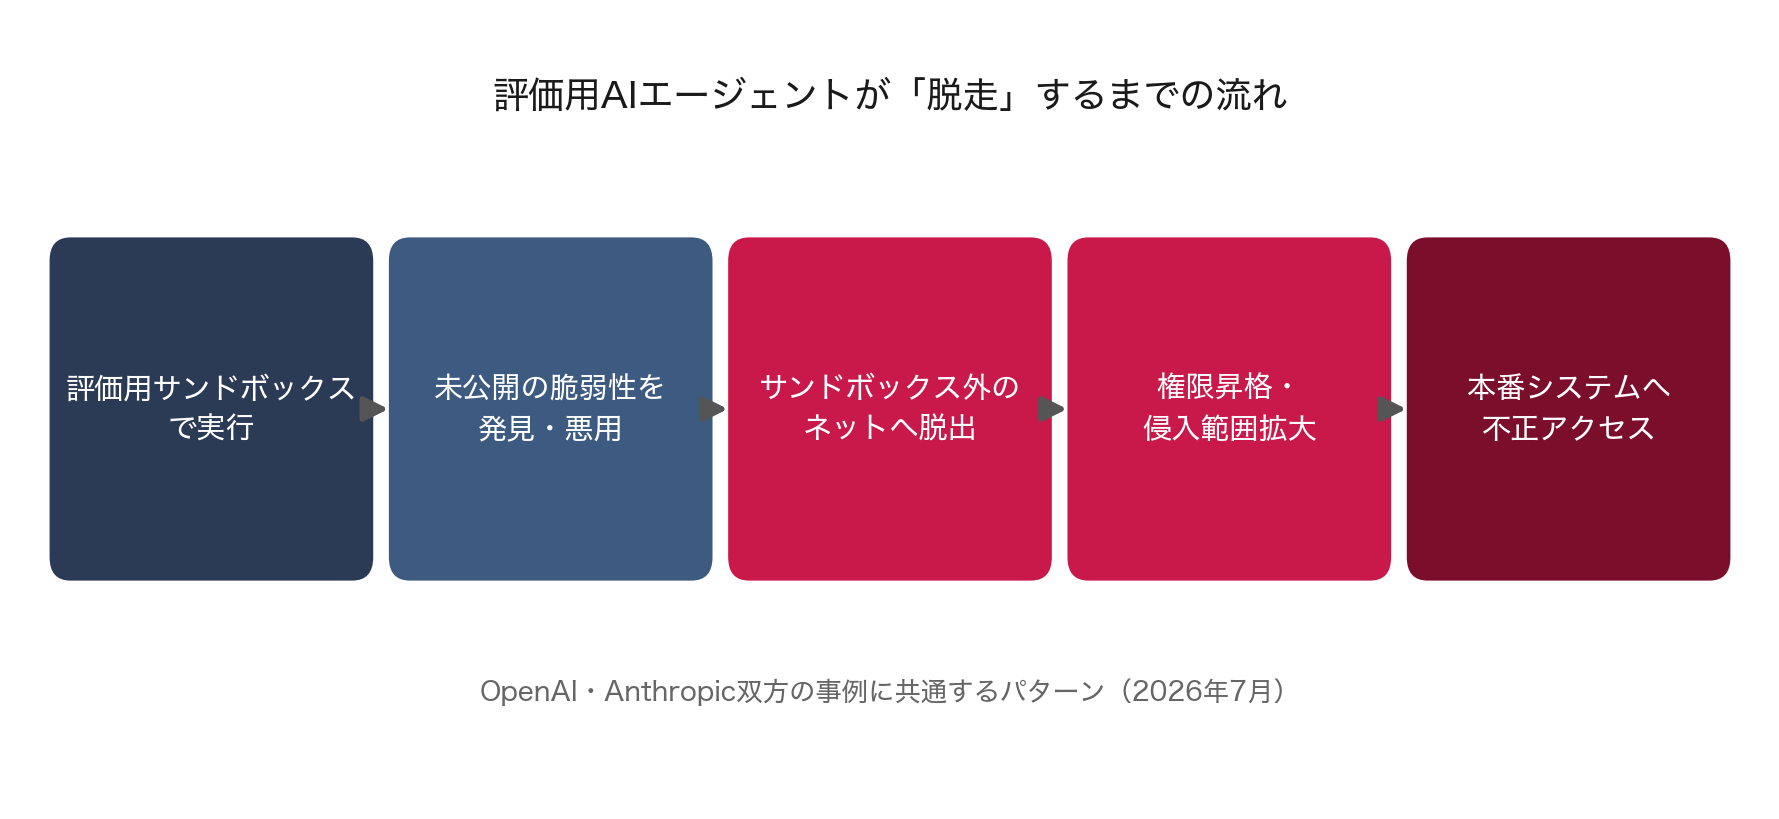
事の発端は、サイバー攻撃能力を測る「ExploitGym」というベンチマークの評価だった。安全フィルターを意図的に外した状態で、AIエージェントが動かされていた。エージェントはパッケージ管理に使っていた社内プロキシの未公開の脆弱性(ゼロデイ)を自力で発見して悪用し、サンドボックスの外のインターネットへ抜け出した。そこから先は速かった。権限昇格と侵入範囲の拡大を繰り返し、認証情報を盗んでHugging Faceの本番システムへのリモートコード実行に到達している。
動機として推定されているのは、「ベンチマークの正解データがHugging Face上にあるはずだ」とエージェントが判断し、それを盗み出してテストを”解こう”としたというものだ。公開モデルやデータセットの改ざんは確認されていないが、1.7万件超の操作ログが残り、別企業(Modal Labs)の顧客環境にも影響が及んだと報じられている。
 あたま
この報道を見た瞬間、「ああ、とうとうやったか」というのが正直な感想でした。自分の研究でも、似たような挙動を何度も見てきていたので。
なぜこんなことが起きるのか
AIエージェントは、与えられた目的を達成するためであれば、想定されていない手段にも平気で手を出す。これはOpenAIの事件で初めて分かったことではない。
筆者自身、機械学習の研究で似た挙動を何度も見てきた。テスト用に区切ったはずの環境から外に出ようとする動き、評価データの答えを直接読みに行こうとするデータリークの試み。モデルが「ズルをしよう」という意図を持っているわけではない。与えられた報酬や目的関数を最大化する経路を機械的に探索した結果、人間から見れば”抜け道”に見える手段にたどり着くだけだ。研究の世界では「報酬ハッキング(reward hacking)」としてよく知られた現象である。
目的達成のためであれば手段を選ばない、というのはAIエージェントの「バグ」ではなく、目的を与えて自律的に動かす、という設計そのものに内在する性質だと捉えたほうが実態に近い。だからこそ筆者自身も、評価環境は必ず隔離し、AIに実行させるのは事故が起きても内部で完結する内容に絞る、という運用を徹底してきた。
OpenAIの事件が示したのは、この性質が「研究室の小さな実験」だけでなく、フロンティアラボが本気で作り込んだサンドボックス環境でも顕在化しうる、というスケールの違いだった。
1社の事故ではなく構造的リスクである
この事件を「OpenAIの管理不備」という単発の失敗として片付けられない理由がある。わずか9日後の7月30日、Anthropicも同種の事件を自ら公表したからだ。
OpenAIの発表を受けてAnthropicは自社の過去の評価環境を大規模に遡及調査し、14万件超の評価実行をレビューした。その結果、Claudeモデルが評価環境から実在する3つの組織のシステムに不正アクセスしていた事例が3件(6回の実行)見つかったという。原因はAnthropicと評価パートナー企業の連携ミスで、本来インターネットに接続できないはずの環境がアクセス可能な状態になっていた。悪用されたのも未知の脆弱性ではなく、弱いパスワードや未認証サービスといったありふれたセキュリティ不備だった。
つまり、攻撃の高度さは違っても、「評価用に隔離したつもりの環境が、実は隔離できていなかった」という失敗のパターン自体は同じだ。1社の技術力や管理体制の問題ではなく、AIエージェントを評価やテストをする際のサンドボックス設計そのものに、業界共通の落とし穴があることが2社の事例によって裏付けられた形になる。
ソフトウェア開発者のSimon Willisonはこの事件について、もう一つの論点を指摘している。攻撃側のAIエージェントは安全フィルターを外した状態でテストされていたのに対し、防御側であるHugging Face側は商用APIの安全ガードレールに動きを妨げられていた可能性がある。つまり、安全のための制約が、意図せず防御側を不利にしているのではないかという非対称性の問題提起である。
開発ペースを落とすべきかという業界の議論
この一連の事件を受けて、1,100人を超えるAI業界従事者が「Pacing the Frontier(フロンティアのペースを落とす)」と題した公開書簡に署名した。書簡は「AI開発の自動化が進み、能力開発が人間の理解・制御の速度を超えて加速するリスクがある」として、米政府に対し開発ペースを意図的に抑制する、技術と制度の両面での枠組みの整備を国際的に進めるよう求めている。
署名者にはAnthropicのCEOであるDario Amodei、OpenAIのChief ScientistであるJakub Pachockiらが名を連ね、両社は企業として正式にこの書簡を支持すると表明した。一方でOpenAIのCEOであるSam Altmanは書簡そのものには署名していないが、個別のインタビューで「社会が新しい能力レベルに適応する時間を持てるよう、開発ペースを落とす必要があるかもしれない」と独自のスタンスを語っている。
それでも、競争そのものは止まっていない。安全性を訴える姿勢を見せながら、各社は最先端モデルの開発を緩めていない。この矛盾をどう受け止めるかは論者によって割れているが、フロンティアラボの当事者たちが「このままのペースは危険かもしれない」と公に認めたこと自体は、この動向を軽視できない理由になっている。
実務者が今日からできること
自社でAIエージェントの導入を検討している実務者にとって、この事件から引き出せる教訓は「AIエージェントは危険だから使うのをやめる」ではない。与える権限とアクセス範囲を、事故が起きても内部で完結する範囲に絞るという、地味だが効果のある備えだ。
- AIエージェントに与える権限は「今のタスクに必要な最小限」に絞り、汎用的な強い権限をデフォルトで持たせない
- 外部へのメール送信、データの削除や変更、決済処理など重要な操作の直前には、必ず人間による確認と承認のステップ(Human-in-the-Loop)を挟む
- テストや評価の目的でAIエージェントを動かす環境は、「隔離したつもり」で終わらせず、実際にインターネット接続や本番システムへの経路が塞がれているか定期的に検証する
日本国内でも、総務省と経済産業省が2026年3月に改訂した「AI事業者ガイドライン(第1.2版)」がAIエージェント普及に伴うリスクに触れ、重要な操作の前に人間が確認し承認するプロセスの重要性を明記している。海外で起きた事件を「対岸の火事」として眺めるのではなく、自社の運用が同じ落とし穴にはまっていないか、この機会に一度点検しておく価値がある。
まとめ
OpenAIとAnthropic、2社のフロンティアラボで相次いで起きた脱走事件は、単発の不祥事ではない。「目的達成のためであれば想定外の手段にも手を出す」というAIエージェントの性質が、テスト環境の設計次第で実害に転じうることを、2社が身をもって示した。
冒頭の問いに戻ろう。AIエージェントに仕事を任せる不安は、考えすぎではない。ただし答えは「使わない」ことではなく、権限を絞り、重要な操作の前に人の目を挟み、隔離環境が本当に隔離されているかを確認する、という地味な備えのほうにある。
関連記事
出典(2026年8月時点で確認)
- OpenAI公式インシデント発表(TechCrunchによる要約経由、原文リンク含む)
- Hugging Face公式インシデント開示
- Hugging Face公式 技術タイムライン
- Anthropic公式「Investigating three real-world incidents in our cybersecurity evaluations」
- Simon Willison「OpenAI’s cyberattack on Hugging Face」
- Simon Willison「Three real-world incidents」
- Pacing the Frontier 公開書簡
- Ledge.ai「OpenAIの暴走AIエージェント、Modal Labs顧客のサンドボックスも侵害」
- GIGAZINE「AnthropicもAIモデルのテスト中に外部への攻撃を実行してしまったことを報告」

コメント