
社外に出せないデータをAIに使わせる方法|ローカルLLM入門と現実的な落としどころ
クライアントの契約書、研究室のデータ、顧客リスト——生成AIに読み込ませたい文章ほど、外部のサービスに貼り付けるのがためらわれる。
- クラウドLLMに情報を渡せないとき、代わりに何ができるか
- ローカルLLM(Ollama)を実際に動かして分かった精度の現実
- 「万能な代替策」ではなく、どこまでなら現実的に使えるか
契約書の下書きチェック、顧客とのやり取りの要約、研究データの分類。生成AIを使えば速いと分かっていても、そこに含まれる情報がNDAで縛られていたり、クライアントの了承なしに外部へ出せない性質のものだったりすると、コピー&ペーストの手が止まる。個人事業主やフリーランス、小規模なチームで動いている場合、社内の情シス部門に相談するような体制もなく、自分で判断するしかない。
この記事では、そうした場面での代替手段としてローカルLLMを検討し、実際にOllamaで動かしてみた結果を書く。結論を先に言うと、ローカルLLMは「クラウドAIの完全な代替」にはならない。ただ、使いどころを絞れば十分に実用的な選択肢になる。
なぜ「外部に出せない」が生成AI活用のボトルネックになるのか
ChatGPTやClaudeのようなクラウドLLMは、入力した文章がサービス提供者のサーバーに送信される。多くのサービスは学習への非利用を選択できる設定を用意しているが、それでも「外部のサーバーを経由する」という事実は変わらない。この一点だけで、以下のようなデータは気軽に貼り付けられなくなる。
- 契約書や秘密保持契約(NDA)の対象になっている情報
- クライアントの了承を得ていない顧客データや案件情報
- 公表前の研究データや実験結果
厄介なのは、これが「使ってはいけない」という明確なルールとしてではなく、「判断がつかないのでとりあえず貼らない」という自主規制として効いてくることだ。結果として、生成AIが最も役に立ちそうな、まさにその機密性の高い業務ほど活用が進まない、という逆転が起きる。
 あたま
いちばん時間を溶かしている作業ほど、いちばん貼り付けにくいデータでできている——これに気づいたとき、クラウドAI一択で考えるのをやめました。
ローカルLLMという選択肢
外部に情報を送らずに生成AIを使う方法として、自分のPC上でモデルを実行する「ローカルLLM」がある。処理がすべて手元のマシン内で完結するため、データが外部に出ることはない。
2026年時点では、Meta「Llama」やAlibaba「Qwen」、Google「Gemma」といったオープンウェイトモデルを、Ollamaのようなツールで手元にダウンロードして動かすのが一般的なやり方になっている。実行環境の選び方にも役割分担があり、まずGUIアプリの「LM Studio」でモデルの精度や速度を試し、開発用のAPIとして使うなら「Ollama」、本番規模の負荷までさばく必要が出てきたら「vLLM」に切り替える、という段階的な使い分けが定番だ(プランタン「ローカルLLM実行環境 徹底比較」)。
個人事業主や小規模チームであれば、まずGUIで試せるLM Studioか、API連携がしやすいOllamaのどちらかから始めるのが現実的だろう。vLLMは本番の大量トラフィックを想定したツールで、個人利用にはオーバースペックになりやすい。
実際にOllamaで動かしてみた結果
概念として知っているのと、実際に自分の作業で使えるかは別問題だ。そこで、Ollamaを使ってLlamaやQwen系のオープンウェイトモデルを手元の環境で実行し、普段クラウドLLMに任せている作業をいくつか試してみた。
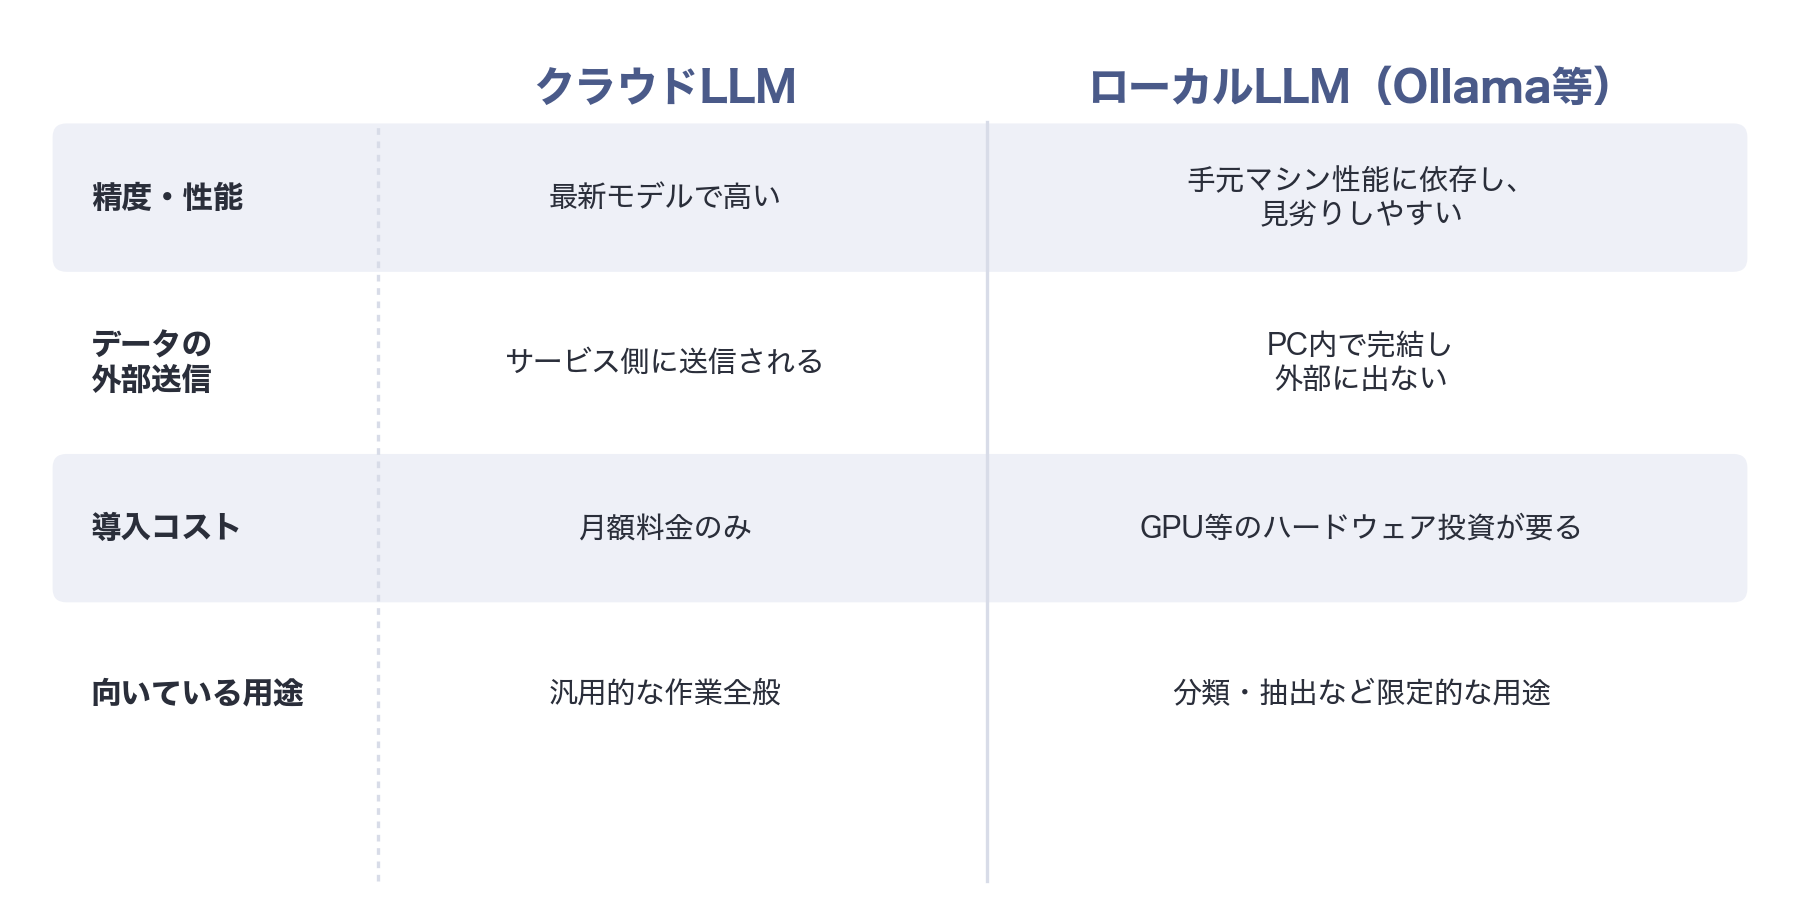
結果は、率直に言って精度や性能の面でクラウドLLMに見劣りした。文章の要約は大意を外さないが表現がやや硬く、複雑な指示を含む依頼では意図を取り違えることもあった。手元のマシンスペックにも結果が左右されるため、「同じモデル名でも人によって体感が変わる」という不安定さもある。
これは想定の範囲内ではあった。クラウドLLMは巨大な計算資源と最新の学習データを背景に持つ一方、ローカルで動かせるモデルは手元のGPUやメモリに収まるサイズに制約される。同じ土俵で戦えば分が悪いのは当然だ。
 あたま
「ローカルLLMに全部任せられたら」という期待は、実際に動かしてみて早々に手放しました。それより「どこまでなら任せられるか」を見極める方が、実務としては意味があると感じています。
その上で見えてきたのが、用途を絞れば十分実用になるという結論だった。長文の要約や複雑な文章生成はクラウドLLMに分があるが、次のような限定的なタスクではローカルLLMでも実務に耐える。
- 問い合わせ内容をカテゴリー別に分類する
- 契約書や議事録から特定の項目(日付、金額、当事者名など)を抽出する
- 定型フォーマットへのテキスト整形
判断の余地が少なく、出力の形式が決まっているタスクほど、モデルの地力の差が結果に出にくい。逆に、文脈を読んで柔軟に判断する必要がある依頼ほど、クラウドLLMとの差が開く。この線引きを持っておくと、「ローカルLLMをどこまで信用するか」の判断に迷わなくなる。
クラウドとローカルのあいだ、という選択肢もある
ローカルLLM以外にも、外部送信の懸念を減らす手段はある。主要なクラウドサービスには、入力データを学習に利用しない契約形態や、専用のプライベートエンドポイントを用意しているものがある。これはクラウドの精度をそのまま使いながら、契約上のデータ取り扱いだけを個別に取り決める方式で、ローカルLLMのような性能面の妥協が要らない。
ただし、こうした契約は多くの場合、個人や小規模事業者が単独で結ぶには手続きのハードルが高い。現実的な選択肢としては、「多くの作業はクラウドLLMを使い、特に機密性の高い一部の作業だけローカルLLMに切り出す」というハイブリッドな運用の方が、個人事業主や小規模チームには馴染みやすいだろう。
ここで大事なのは、「入力してよいデータの範囲」と「入力してはいけないデータの範囲」を、あらかじめ具体的な業務例で線引きしておくことだ。線引きが曖昧なままだと、結局「念のため貼らない」という自主規制に逆戻りしてしまう。
この線引きの発想は、社内でナレッジを扱う仕組みづくりとも地続きだ。誰か一人の頭の中にしかない判断基準を、具体的なルールとして外に出しておく、という考え方は、次の記事で扱った属人化の構造とも重なる。
社内データをAIに「渡す」仕組みそのものを見直す
ローカルLLMは「外部に送らない」という守りの選択肢だが、もう一つ検討したいのが、AIに渡すデータの見せ方を工夫する方向だ。機密情報そのものではなく、必要な部分だけを検索して渡す仕組み(RAG)を組めば、そもそも全文を渡さずに済むケースもある。
「ローカルLLMで守る」「渡す範囲をRAGで絞る」「一部はクラウドとの契約形態で解決する」——どれか一つが正解というより、扱っているデータの性質によって組み合わせを変えるのが現実的だ。
ローカルLLMで動かすLlama・Qwen・Mistralといったオープンウェイトモデルそのものの実務適性については、以下の記事でも規制論争と現場の実感の両面から掘り下げている。
まとめ
機密性の高いデータを抱えていると、生成AI活用は「クラウドか、諦めるか」の二択に見えがちだが、ローカルLLMという第三の道がある。ただし今回の実機検証で分かったとおり、精度面でクラウドLLMに劣るのは事実で、「なんでも任せられる代替策」として過信するのは禁物だ。分類や抽出のような判断の余地が少ないタスクに絞って使う、あるいはクラウドとローカルを使い分けるハイブリッド運用にする。この現実的な落としどころを起点に考えると、機密データを理由に生成AI活用そのものを諦めずに済む。
同じような制約を抱えている方の参考になれば幸いです。データの扱い方も含めた生成AI活用の設計について相談したい方は、生成AI活用・ナレッジ構築コンサルティングのページもご覧ください。
関連記事

コメント