
「貯めるナレッジ」から「AIが動かすナレッジ」へ|2026年の社内ナレッジ管理再設計
社内Wikiには何百ページも資料がある。それなのに、新しく入ったメンバーは「どこを見ればいいか分からない」と言い、ベテランは今日も口頭で答えている。情報は貯まっているのに、使われていない。
この状態を見て、たいていは「整備がまだ足りないからだ」と考える。分類をやり直し、テンプレートを配り、棚卸しの旗を振る。筆者もそう考えて動いていた時期がある。
ところが2026年、この問題の解き方そのものが変わりつつある。整備の総量ではなく、誰のために整備するのかという前提が動いた。
- 貯めたナレッジが使われないまま終わる4つの型
- 2026年に起きている設計思想の転換と、それを裏付ける数字
- AI向けにドキュメントを書き直すとき、実際に何を変えるのか
- 「整備してから」ではなく「動かしながら」進めるための入口
貯めたナレッジが使われないまま終わるとき
「使われないナレッジ」は一つの症状ではない。筆者が社内で生成AIの活用を推進する立場で見てきたかぎり、少なくとも4つの異なる型がある。
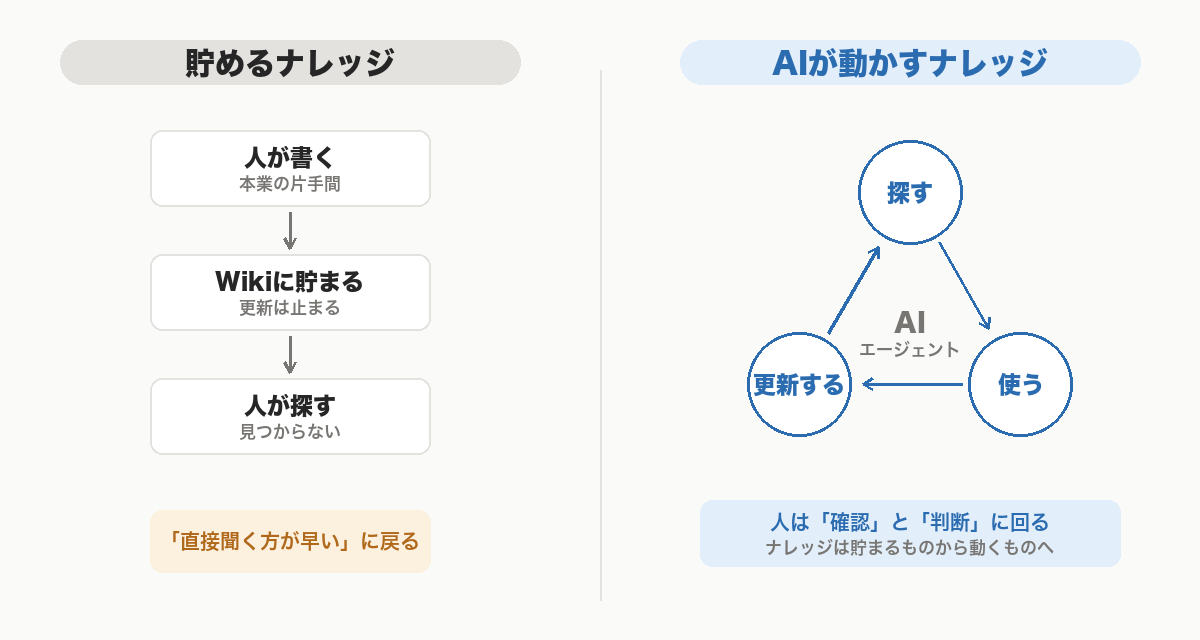
- 探せない:情報はあるはずなのに検索で出てこず、結局「詳しい人に直接聞く」に戻る
- 書く手間が誰かの追加業務になっている:ナレッジ入力が本業の片手間に置かれ、忙しい人ほど書かない。結果、一番残したい知見が残らない
- 更新責任者が不在で陳腐化する:書いた本人が異動・多忙になった時点で古いまま放置され、誰も信用しなくなる
- AI検索を入れたのに精度が出ない:社内文書をRAGに投入したものの、元の文書がAI向けでないために的外れな回答が返る
上の3つは、生成AI以前から知られた古典的な失敗だ。書くのも探すのも更新するのも人の善意でまかなう以上、業務が忙しくなるほど後回しになる。属人化はなぜ起きる?ノウハウを組織の資産にする4つのアプローチで整理した構造と同じもので、ナレッジ基盤を導入しただけでは解けない。
4つめだけが、質の違う失敗である。
 あたま
社内文書をそのままRAGに突っ込んで、精度が出なくて頭を抱えた経験があります。文書自体は間違っていないんです。ただ、人間なら前後関係で補える略語や社内固有の前提が書かれていないせいで、AIは平気で的外れな回答を返してくる。
つまり、投入した文書は「人が読む」ことを前提に書かれていた。読み手が社内の文脈を共有している前提で、省略が効いていたわけである。その省略が、読み手をAIに替えた瞬間に欠陥に変わる。
2026年、ナレッジは「動くもの」として設計されている
2026年の論調は「情報をどう貯めるか」から「なぜ貯めた情報が使われないのか」へ移っている。答えとして提示されているのが、探す・使う・更新するのサイクルにAIエージェントを組み込み、ナレッジを「貯まるもの」から「動くもの」に変えるという設計である。
2023年から2024年にかけて広まったRAG(検索拡張生成)が解決したのは、社内文書への質問応答という検索の精度だった(仕組みはRAGとは?仕組み・チャンク分割・ベクトルDBを初心者向けに解説で扱っている)。原本を書き足したり鮮度を保ったりする部分は、人の担当のまま残されている。
2026年に語られているのは、その先だ。AIエージェントが検索した情報を使って業務を実行し、さらにサポートチケットや問い合わせログを分析してFAQの下書きを自動生成し、人の確認を経て公開する。更新のサイクルそのものに機械を入れる、という発想の転換になる。
Gartnerは2025年8月26日のプレスリリースで、2026年末までに企業アプリケーションの40%にタスク特化型AIエージェントが組み込まれると予測した。2025年時点では5%未満とされているので、1年強で8倍以上の普及を見込んでいることになる。
メルカリが公開した数字と、その中身
国内でこの転換に最も具体的に踏み込んだ事例を公開しているのが、メルカリである。同社は2025年に全社での「AI-Native」転換を宣言し、公式のエンジニアリングブログ(2025年12月)で次のような数字を報告している。
- 社員の95%がAIツールを活用している
- コード生成の約70%をAIが担っている
- 開発スピードが前年比で64%向上した
注目したいのは数字そのものより、同社がこれを支えるものとしてナレッジ管理を挙げている点である。AIエージェントが機能するには適切なコンテキストの提供が欠かせないとして、意思決定ログや設計書を「AI-Readable」な状態に構造化し、複数ツールに散っていた情報をNotionへ集約した。1か所にまとめること自体が、AIの接続コストを下げる施策として位置づけられている。推進体制も33ドメイン・約100名規模のAI Task Forceと、片手間ではない。
 あたま
この規模の投資ができる会社ばかりではない、というのは正直な感想です。ただ、ここで真似すべきなのは体制の大きさではなく、「ナレッジ整備をAI活用の前提条件として扱った」という判断のほうだと思っています。
ただし同社自身、これらの数字を掲げつつ「本当に生産性は飛躍的に向上したのか」と問い直し、改善の余地は大きく残ると述べている。完成形ではなく途中経過として読むのが妥当だろう。
AI向けに書き直すとき、実際に何を変えるのか
では、自社のドキュメントを「AIが参照するコンテキスト」として設計し直すとき、具体的に何をいじることになるのか。筆者が個人のナレッジ基盤(Obsidianで運用しているknowledge-wiki)と社内の文書の両方で手を動かした範囲では、効いたのは次の3点だった。
- 粒度と構造を変える:1ファイルに1トピックを守り、見出しで内容が特定できるようにする。長大な議事録や網羅的なマニュアルは、AIが必要な部分だけを切り出しにくい
- 暗黙の前提を明文化する:社内固有の略語、部署名の通称、「言うまでもない」とされてきた手順の前提条件を、文書の中に書き込む
- 分散したツールを集約する:チャット、共有ドライブ、Wiki、チケットに散った情報を1か所へ寄せる。メルカリがNotionへ集約したのと同じ理屈で、接続先が減るほど参照は安定する(筆者が同じ判断をしたときの経緯は複数のAIサービスをどう連携させるか?情報をNotionに集約した理由に書いた)
このうち2つめが、一番手強い。暗黙の前提は、書き手にとって暗黙だからこそ書かれていない。何が抜けているかはAIが誤答したときにはじめて姿を現す。「この略語を知らないと答えられなかったのか」と後から気づく、という順序になる。
3点それぞれを、実際の文書のどこをどう書き換えるかというレベルまで落とした手順はAIが読めるドキュメントの書き方|社内文書を「AI-Readable」に直す3つの手当てにまとめた。
AIの誤答は、単なる不具合ではなくナレッジの穴を指し示す検出器として使える。どこで間違えたかを記録していけば、どの前提が明文化されていないかが業務単位で見えてくる。
なお、この「AIに知識を渡す」という課題には、文書を検索させるRAG以外の選択肢もある。知識のフォーマット自体を標準化する方向の議論はRAGとOKF、AIに知識を渡す2つの方法で、チャットサービス側の記憶機能との使い分けは公式メモリ機能とナレッジ基盤はどう使い分けるかで扱っている。
整備してからAIを入れるのか、AIを入れながら整備するのか
「うちはナレッジが整っていないから、AIはまだ早い」という言い方は、どの現場でも聞く。もっともな判断に聞こえるし、実際そう答えたくなる場面もある。
ただ、この順序で進めた取り組みが完走したのを、筆者はほとんど見ていない。整備には終わりがなく、「終わったら次へ」の「終わった」がいつまでも来ないからだ。しかも、どの前提が抜けているかはAIを動かすまで分からない。整備を先に完了させる計画は、必要な情報が手に入る前に完了判定をしようとしていることになる。
実務で機能したのは逆の順序だった。問い合わせが多い1業務にまずAIエージェントを置き、誤答が出たところから埋めていく。範囲が狭いぶん誤答の影響は限定でき、埋めるべき穴は具体的な質問という形で降ってくる。
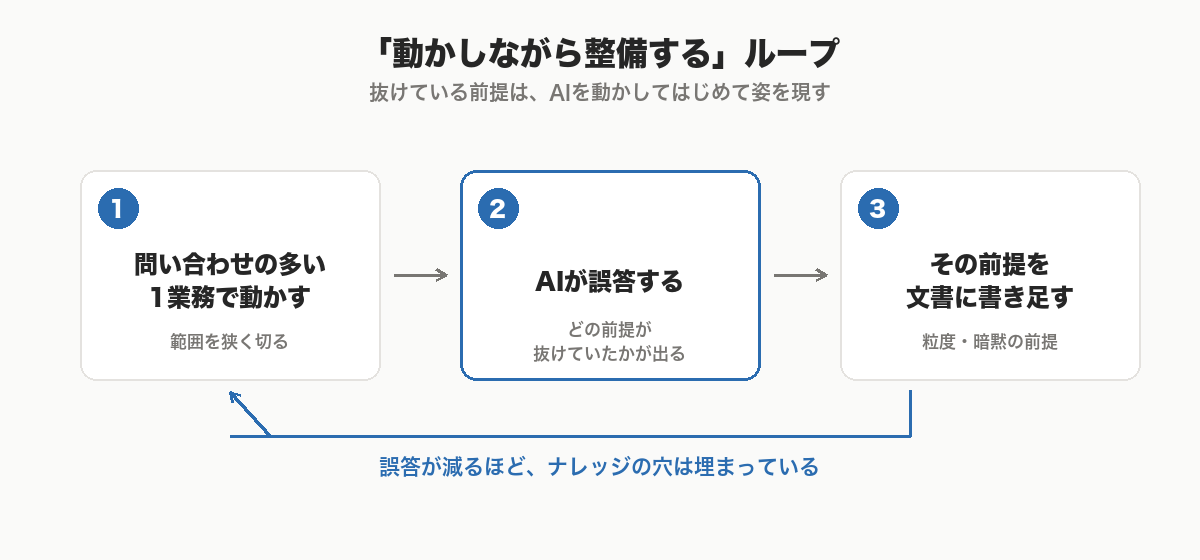
とはいえ、何も決めずに動かし始めるわけにはいかない。着手前に答えを出しておきたいのは、次の3つに絞れる。
- どの業務で、どんな問い合わせが多いかを洗い出す
- その回答に必要なドキュメントを特定できるかを確かめる
- エージェントが誤答したとき、誰が直すのかを決めておく
3つめは技術の話ではなく、運用の話である。そして実際に取り組みを止めるのは、たいていここだ。
進まない理由は、たいてい技術の外側にある
Gartnerは2025年6月25日の別のプレスリリースで、agentic AIプロジェクトの40%超が2027年末までに中止されると予測している。3,400を超える組織への調査に基づくもので、理由はコストの膨張、事業価値の不明確さ、リスク統制の不足とされる。普及の予測と中止の予測は、同じ会社から並んで出ている。
社内で推進する立場から見て、実際に足を止めたのは3つだった。いずれも技術の問題ではない。一つめは、どの文書までAIに読ませてよいかの線引きが決まらず、決裁が宙に浮くこと。二つめは、誤答したときに誰が直すのかが空白のままで、運用に乗せる判断ができないこと。三つめは、現場が「直接聞く方が早い」から動かないことだ。既存の習慣と人間関係のほうが、新しい仕組みより手触りとして確かに見える。
三つめは、人材流出は「人の損失」ではなく「知識の損失」であるで扱った問題と地続きにある。「直接聞く方が早い」が機能している間は誰も困らず、その人がいなくなってはじめて損失が表面化する。再設計が後回しにされ続けるのは、コストが遅れて現れるからだ。
一つめと二つめは、対象を狭く切ることで前に進めた。全社の文書ではなく1業務の文書に限り、その範囲でだけ公開範囲と修正担当を決める。全社の線引きは合意が取れないが、1業務ぶんなら決められることが多い。
三つめについては、現場のAI習熟度がばらついたまま仕組みだけ導入しても動かない、という別の論点が絡む。この設計は生成AI上級者だけじゃないチームで、ナレッジ活用はどう設計するか?で扱っている。
まとめ
社内Wikiに情報が貯まっているのに使われない。これを「整備が足りない」と診断して分類をやり直すと、たいてい同じ場所に戻ってくる。書くのも探すのも更新するのも人の善意に依存している以上、忙しくなれば止まるからだ。
2026年の転換は、そのサイクルにAIエージェントを組み込むところにある。メルカリがナレッジ整備をAI活用の前提条件として扱ったように、「人が読む文書」を「AIが参照するコンテキスト」として書き直す。粒度を細かくし、暗黙の前提を書き出し、参照先を1か所に寄せる。この3つが、書き直しの実務の中身になる。
冒頭の「どこを見ればいいか分からない」という新メンバーの言葉も、参照の窓口がAIエージェント側に用意されていれば、そもそも発生しにくい。まずは問い合わせの多い1業務を選んで動かしてみる。どの前提が抜けているかは、動かしてはじめて教えてもらえる。自社のどの業務なら、公開範囲と修正担当をいますぐ決められるだろうか。再設計の入口は、たぶんそこにある。
関連記事

コメント