
「LLM Wiki」提唱者Karpathyが、Anthropicで「AIに自分自身を改善させる」に挑む理由
AIにナレッジベースを編纂させる。ここまでは、もう聞き慣れた話かもしれない。では、AIに研究そのものを担わせるとしたら、どこまで進めるだろうか。
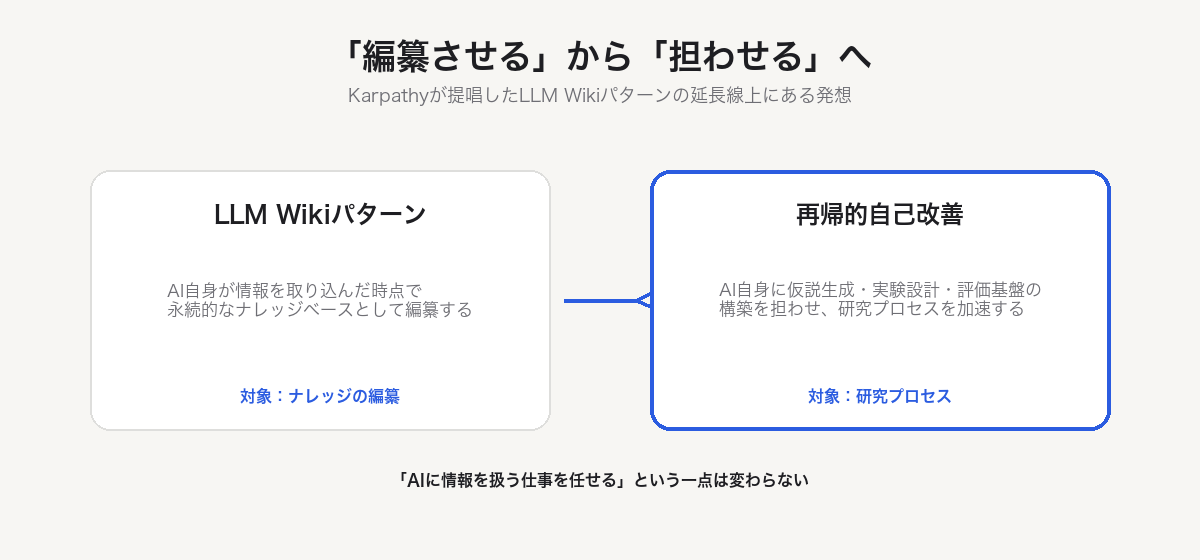
「LLM Wiki」というパターンをご存じだろうか。本サイトでも「AIを第二の脳にする」LLM-wikiという設計思想で紹介した、LLM自身に永続的なナレッジベースを編纂させるという設計思想である。その提唱者であるAndrej Karpathyが、2026年5月にもう一段先へ進んだ。
- Karpathyが「LLM Wiki」の次に選んだ、Anthropicでの役割
- 「ナレッジを編纂させる」と「研究を担わせる」に共通する発想
- 2026年8月時点で見えてきた、進んでいる部分と壁にぶつかっている部分
- 研究現場でAI活用を推進する立場から見た、同じ壁の実感
Karpathyとは何者か
Andrej Karpathyは、2015年のOpenAI共同創業メンバー11人の一人である。スタンフォード大学でFei-Fei Liの下に学び、Tesla AI部門でAutopilotの開発を率い、2024年には教育スタートアップEureka Labsを創業した。研究者としても教育者としても知名度の高い人物だ。
lab読者にとってより関係が深いのは、彼が「LLM Wiki」パターンの提唱者でもあるという事実だろう。クエリのたびに文書を検索するRAGに代えて、LLM自身が情報を取り込んだ時点で永続的なMarkdownとして編纂してしまう、という設計思想である。この考え方はObsidianとは?AI時代に見直される個人の知識管理(PKM)の基本やOKF(Open Knowledge Format)とは?でも触れてきた、labのPKM系記事群の土台の一つになっている。
2026年5月、Anthropicの事前学習チームへ
その提唱者が、2026年5月19日、Anthropicへの参加を発表した。Nick Joseph率いる事前学習(pre-training)チームの中に、新しいグループを立ち上げる役目である。
掲げている目標は明確に再帰的だ。Claudeを使って、Claude自身の事前学習研究を加速させる。事前学習はフロンティアモデル開発の中でも最も計算量が多く、コストのかかる工程とされる。ここに仮説生成、実験設計、文献レビュー、評価基盤の構築までAIに担わせようという試みである。
発表のX投稿は1,360万ビューを記録した。Karpathyは「今後数年間のLLMの最前線は特に形成的な時期になる」と述べている。背景には、OpenAIが過去2年で十数名の幹部や研究者を失う一方、Anthropicが評価額8,000億ドル規模へと急成長し、トップ研究者を引き寄せる磁力になっているという業界地図の変化もある。Karpathy以降もNobel賞受賞者John Jumper(6月)、UC Berkeley CS学科長Jelani Nelson(7月)と、著名な採用が続いた。
「ナレッジを編纂させる」の延長線上にある発想
LLM Wikiパターンの核心は「AI自身に、情報を扱う仕事を任せる」という一点にある。ナレッジベースの編纂を任せていた対象が、研究プロセスそのものに広がった。そう捉えると、今回の役割は突飛な方向転換ではなく、同じ発想の延長線上にあるとわかる。
筆者自身、研究現場で生成AI活用を推進する立場から、この連続性には実感がある。knowledge-wikiは「Raw→Knowledge→Thinking→Writing」という4層構成で運用しているが、Karpathyの3層(Raw→Wiki→Schema)と見比べると、自分のvaultには彼のパターンに明示的には存在しない層が1つ多い。Thinking/(人間が裏取りをして解釈し、確定させるレビューゲートの層)である。
 あたま
研究データを扱っていると、AIの要約をそのまま信じて資料に書くと痛い目を見る、という感覚が染みついていました。だから最初から人間の確認を挟む設計にしていたんですが、Karpathyの元のパターンを読み返してみると、この層は明示的には無い。自分は無意識のうちに、より保守的な設計をしていたんだと気づきました。
実際、2026年6月頃、Knowledge/層に書かれた内容をAIがそのまま部下向け資料に転記しようとした場面があった。出典が曖昧な推論(vault内では^[inferred]とタグ付けしている部分)だったが、Thinking/層で一度人間が確認する運用にしていたおかげで、そのまま資料化されるのを止められた。「AIに任せる」設計をどこまで広げるかは、こうした小さな線引きの積み重ねで決まる。
伸びている数字と、まだ超えられない壁
Karpathy参加から間もない2026年5〜6月、Anthropicは自社の再帰的自己改善への進捗を数値で公開した。レポート「When AI Builds Itself」が示す数字は、確かに伸びている。
- 本番コードベースへのマージの80%以上がClaude作成(2025年2月以前は1桁台)
- エンジニア生産性は2024年比8倍(2026年第2四半期)
- 自律タスク実行時間は4ヶ月ごとに倍増(2024年3月の約4分から、2026年3月には12時間まで拡大)
ただし同レポート自身が、こう釘を刺してもいる。「We are not there yet, and recursive self-improvement is not inevitable(まだそこには至っていないし、再帰的自己改善は必然でもない)」。人間の研究判断が必要な領域には、依然としてギャップが残るとされる。
2026年8月18日、MIT Technology Reviewはそのギャップを具体的に示す実証実験を報じた。Princeton大学がClaude Opus 4.8にNeurIPS 2026投稿論文相当の研究課題を6日間かけて解かせたところ、生成された両論文とも査読で不採択になった。文献レビューや数百件規模の実験実施はこなせたが、仮説を十分に探索せず、既知の方法にすぐ固執するという限界が指摘されている。
Anthropic共同創業者のJack Clarkも「今日のAIシステムには価値のある直感的創造性がない」と述べ、短期的な再帰的自己改善のタイムラインには弱気な見方を示している。Karpathy個人やその新チームの具体的な成果への言及はまだない。伸びている指標(コード生成やタスク実行時間)と、伸び悩んでいる領域(仮説探索や研究の創造性)が、はっきり分かれ始めている。
研究現場で、同じ壁にぶつかった話
この分かれ目には、筆者自身も心当たりがある。2026年7月頃、研究現場での実験の失敗パターン分析にClaude Codeを使わせてみた。knowledge-wikiのRaw層に格納していた過去の実験ログを読ませ、「次に試すべき条件」を提案させたのである。
結果は、提案の8割が既に人間が却下済みの条件の焼き直しだった。残り2割の中に、人間が見落としていた変数の組み合わせの提案が1つだけあり、それは実際に試して意味のある結果につながった。
 あたま
この経験から、自分なりの使い分けの感覚ができました。生成AIは、新規の発想(誰も考えていなかった実験条件や仮説そのもの)を生み出すことには、まだ至っていない。でも「なぜその実験が失敗したか、何を改善すべきか」という原因追求は、かなり高い精度でこなしてくれます。強みは”ゼロから発想する”側ではなく、”起きたことを分析し尽くす”側にある、という感覚です。
これは、Princeton大学が報告した「エージェントは仮説を十分探索せず既知の方法に固執する」という限界と、方向性が一致する。研究プロセスの中には、AIが既に高精度でこなせる部分と、まだ人間の判断を必要とする部分がはっきり分かれている。Karpathyが目指す事前学習研究へのClaude活用も、まずはこの同じ壁にぶつかるはずだ。
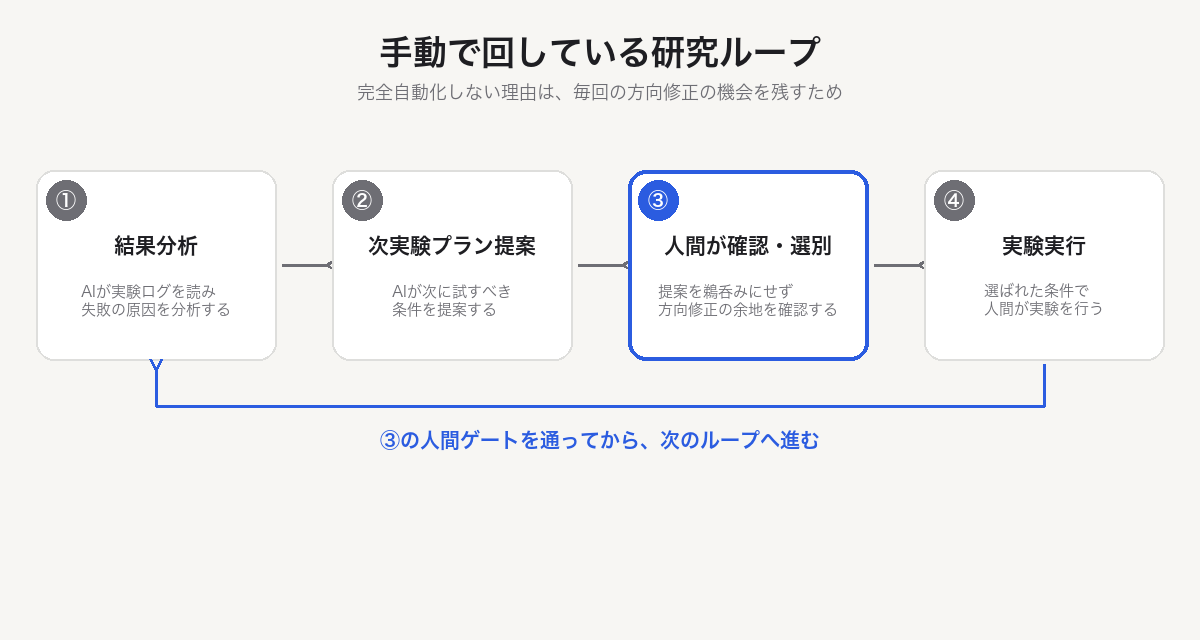
だからこそ筆者は今も、knowledge-wikiを起点にした「AIによる結果分析→次実験プラン提案→(人間が選別して)実験実行→実験結果分析」というループを、あえて手動で回している。完全に自動化してしまうと、あらぬ方向に進んでしまうことがあるからだ。次の実験プランをAIが提案するたびに、人間が確認する。この一手間を残すことで、方向修正の機会を毎回確保している。前述のThinking/層と同じ発想を、研究ループの中に実装した形だ。
まとめ
Karpathyが「LLM Wiki」で示したのは、AIに情報の編纂を任せるという発想だった。Anthropicでの新しい役割は、その任せる範囲を研究プロセスそのものへ広げる試みである。
2026年8月時点で見えているのは、コード生成やタスク実行時間のように急速に伸びている指標と、仮説探索や研究の創造性のようにまだ壁にぶつかっている領域が、はっきり分かれ始めているという状況だ。筆者自身の研究現場での経験も、この分かれ目と重なる。原因追求はAIに任せられても、新規の発想はまだ人間の役割として残っている。
再帰的自己改善が実務レベルでどこまで進むかは、この分かれ目のどちら側が先に動くかにかかっている。ナレッジ管理でも研究プロセスでも、「どこまでAIに任せ、どこに人間の判断ゲートを残すか」という線引きは、Karpathyのような最前線の研究者にとっても、個人のvaultを運用する一人の実務者にとっても、同じ問いとして立ち上がってくる。
あたまこの記事が役に立てば嬉しいです。よかったら他の記事も見てみてくださいね。
関連記事

コメント