
知識管理のパラドックスとは|知識は増えるほど使えなくなる4つの構造
「これ、前にも似たようなことを調べた気がする」。検索しても出てこない。出てきても、それが今の状況にそのまま使えるのか、判断がつかない。ノートやWikiは増え続けているのに、肝心なときほど役に立たない。
たいていは「整理が足りないからだ」と考える。タグを付け直し、フォルダを再編し、検索性を上げようとする。筆者も研究現場で生成AIの活用を推進する立場で、個人のナレッジ基盤(Obsidianで運用しているknowledge-wiki)を育てながら同じことを繰り返してきた。
だが整理をどれだけ丁寧にやっても、この感覚は消えなかった。理由は、そもそも「知識を増やすこと」と「知識を使える状態にすること」が別の作業だからだ。
- 知識が増えるほど扱いにくくなる、4つの現象の構造
- 「蓄積」と「使える状態にすること」が別問題である理由
- 使える状態を保つために、実際に何をすればいいか
「知識を増やす」と「知識を使える状態にする」は別問題だ
社内Wiki、個人のPKM、研究ノート。形は違っても、知識管理がうまくいかなくなる展開はよく似ている。最初は快調に増えていく。半年、1年と経つうちに、増えているはずなのに前より不便になる。
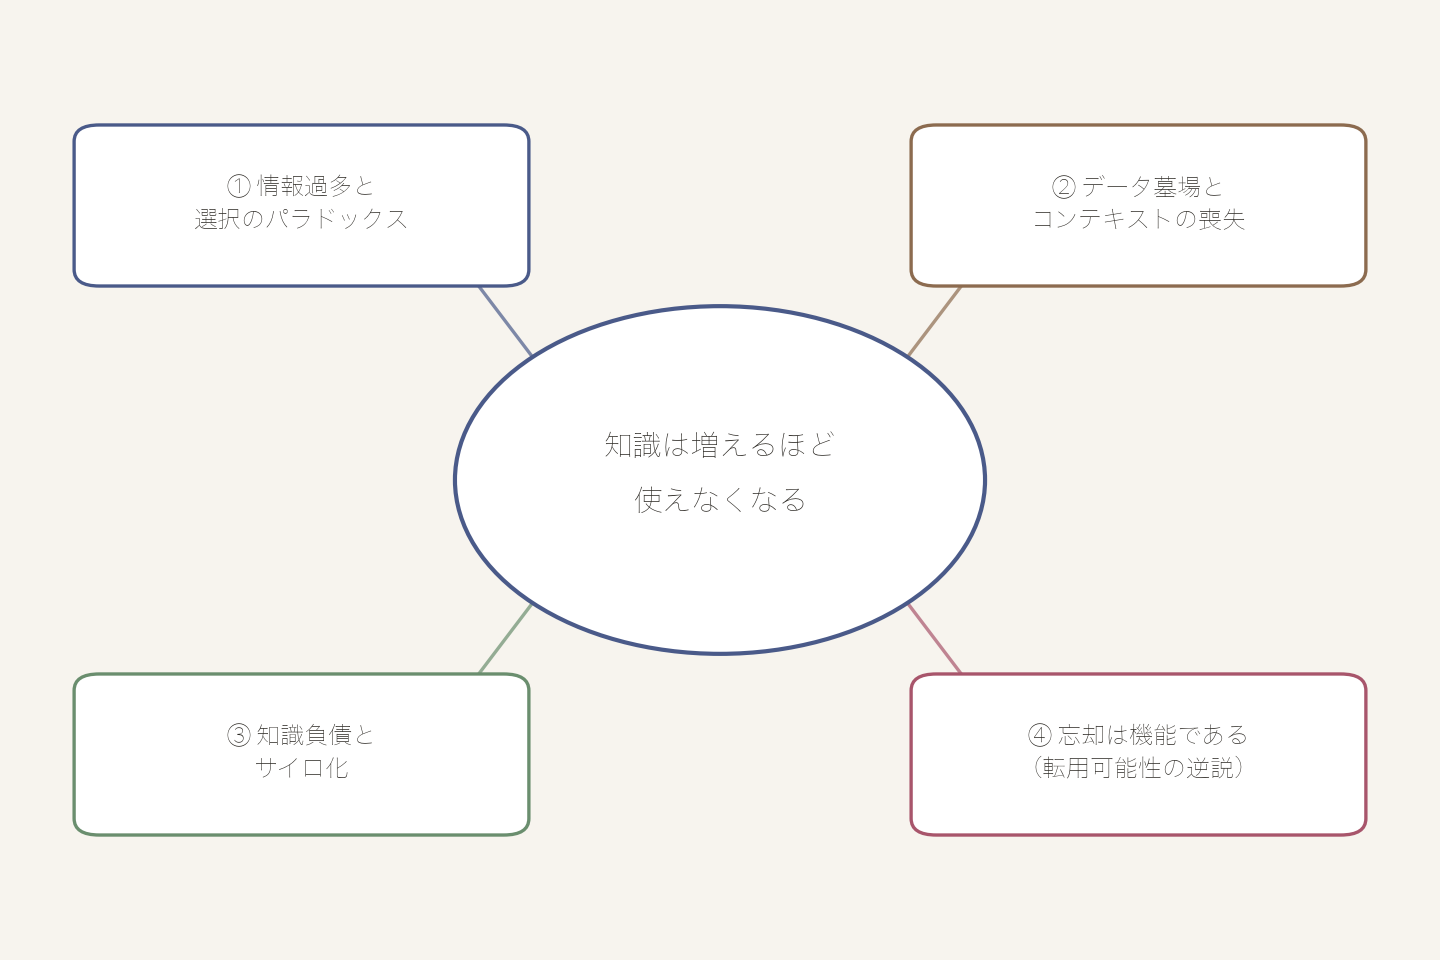
この不便さの正体は、たった一つの現象ではない。知識管理の研究や実務では、少なくとも4つの異なる現象がそれぞれ独立に効いてくる。共通しているのは、どれも「蓄積」を続けているだけでは解決しないという点だ。
知識が増えるほど使えなくなる4つの現象
1. 情報過多と選択のパラドックス
ハーバート・サイモンは1971年、「情報の豊かさは注意の貧困を生む」と定式化した。情報は無コストで消費できる資源ではなく、受け手の注意力という有限資源を消費する。情報が増えるほど、相対的に注意は希少になっていく。
さらに、バリー・シュワルツが2004年に示した「選択のパラドックス」が重なる。選択肢が増えるほど満足度が下がり、決定を先送りする傾向が強まる現象で、24種類のジャム売り場の実験が有名だ。
 あたま
これは検索性を上げるだけでは解けません。目的の情報にたどり着く「検索コスト」と、たどり着いた後にどれを採用するか決める「選択コスト」は別のボトルネックで、両方に手を打つ必要があります。
2. データ墓場とコンテキストのエントロピー増大
蓄積されたデータは、放置すると「あるはずだがどこにあるか分からない」を経て、さらに厄介な「見つけても今の状況に使えるか分からない」状態に至る。企業データの60〜73%が分析に使われず放置される「ダークデータ」問題として、Gartnerが実証している。
問題の中心は、メタデータ、分類、ガバナンス文脈の欠如だ。データそのものは残っていても、それが今も信頼できるか判断する材料がない。知識は蓄積された時点では「実験結果Xがある」という確定した状態にあるが、時間とともに「何の目的で取得したか」「どんな条件だったか」という付随情報が失われ、意味が拡散していく。
3. 知識負債とサイロ化
ソフトウェア開発の「技術的負債」は、ウォード・カニンガムが1992年に編み出した比喩だ。粗いコードは短期的に開発を加速させるが、リファクタリング(返済)を怠ると利子(将来のコスト増)が積み上がる。
知識にも同型の構造がある。知識A→知識B→知識Cと積み上げるうちに、個々の知識そのものより知識同士の依存関係が複雑化し、一部を更新すると別の前提が崩れる、全体を把握できる人がいなくなる、という状態に陥りうる。技術的負債と違うのは、知識負債の多くは意図的に取るものではなく、気づかないうちに蓄積される受動的なプロセスだという点だ。
これに、組織のサイロ化が重なる。2024年の調査では、68%の組織がデータサイロや知識サイロを主要課題として挙げている。部門ごとに知識は蓄積されているのに、部門間で接続されない。個人のPKMでも同型の現象は起きる。ノートが増えるほど、意識してリンクを張らない限り、テーマ同士が孤立していく。
4. 忘却は機能である
ここまでの3つより一段深いのが、この逆説だ。経験や知識の量が増えるほど、それを別の問題に転用する能力がかえって下がりうる。転用可能性のパラドックスと呼ばれる現象である。
- 経験1:「この条件ではこうなる」(単純で転用しやすい)
- 経験100:「この条件ではこうなる。ただしAの場合は例外……」(例外条件が付随し始める)
- 経験1万:膨大な例外、条件、背景知識が付随する(専門家には精緻だが、初心者や別領域の人には「結局どう使えばいいか分からない」)
知識は量として増えているのに、使える形からは遠ざかっていく。
ヒントは脳の仕組みにある。脳は全てを記憶するのではなく、忘却(シナプス刈り込み)によって適応性を維持している。想起されない記憶の神経結合は、能動的に弱められる。忘却は劣化ではなく、機能なのだ。
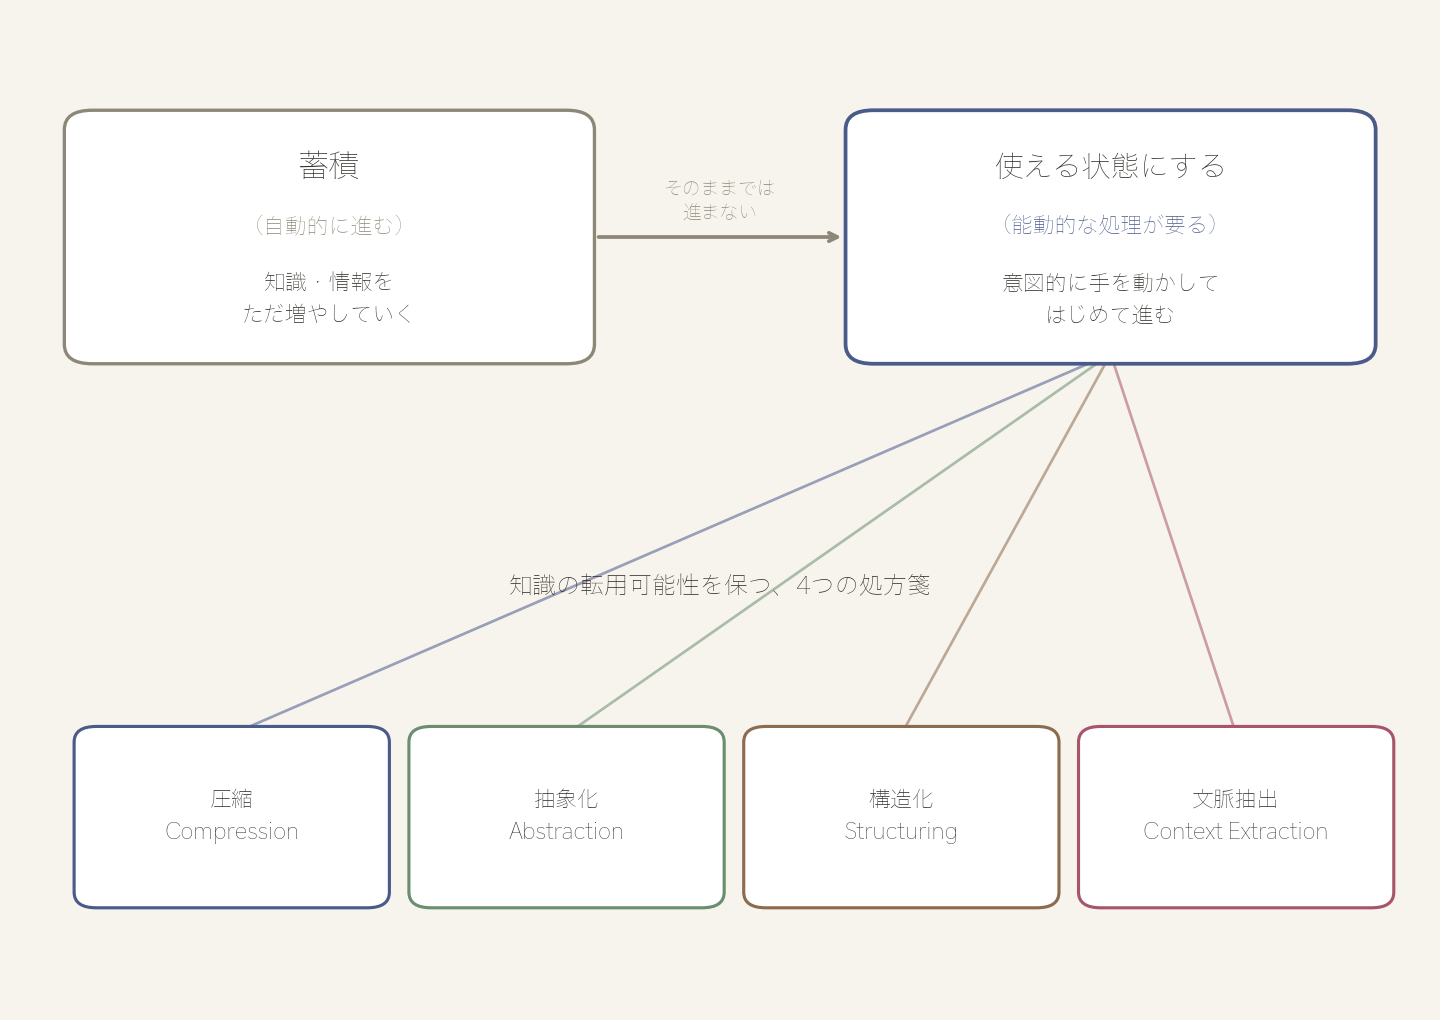
蓄積は自動に進むが、使える状態化は能動的な処理が要る
情報過多、データ墓場、知識負債、転用可能性の低下。4つは一見バラバラだが、根っこは同じところにある。
「蓄積」は放っておいても進む。しかし「使える状態に保つこと」は、意図的に手を動かさない限り進まない。ノートを書く、資料を保存する、といった蓄積行為は自動的に増えていくが、それを整理し直し、抽象化し、文脈を残す作業は、誰かが能動的にやらない限り発生しない。
つまり「知識管理がうまくいかない」の多くは、蓄積が足りないのではなく、蓄積と同じペースで「使える状態化」の処理が回っていないことが原因になる。
使える状態を保つための処方箋
脳の忘却機能からの示唆を、知識管理に当てはめると、次の能動的な処理が浮かび上がる。
- Compression(圧縮):例外や条件を削ぎ落とし、本質的な構造だけを残す
- Abstraction(抽象化):個別事例から、一般化可能なパターンを取り出す
- Structuring(構造化):知識同士の関係を明示し、依存関係を追跡可能にする
- Context Extraction(文脈抽出):その知識がどの条件下で成立するかを明示的に保存する(データ墓場問題の裏返し)
「知識を増やすこと」と「知識を使える状態にすること」は、そもそも別の問題である。後者には、蓄積とは異なる能動的な処理が要る。
Raw→Knowledgeの2段階処理という実装
筆者が個人で運用しているknowledge-wikiでは、Web調査や執筆中に得た知見をまずRaw/memo/にそのまま格納する。この時点ではただの蓄積で、上で説明した4つの現象がそのまま起こりうる状態だ。
あたまここで止めると、Raw/memo/はどんどん「データ墓場」になっていきます。実際、格納しただけで満足して放置したメモが、後から検索しても文脈が思い出せず使えなかったことが何度もありました。
そこで、テーマがある程度まとまった段階でKnowledge/へ統合する。要約を書き(圧縮)、既存の概念ページと接続し(構造化)、出典や前提条件を明記し(文脈抽出)、必要なら複数の事例から一般化した記述に書き直す(抽象化)。この一手間が、まさに4つの処方箋をそのまま実装したものになっている。
この処理は「気が向いたときにやる」のではなく、次に同じテーマを書くときすぐクエリで拾える状態まで持っていくことをルール化してある。ルール化していない作業は、忙しさに負けて後回しになり、いつまでも「蓄積」のまま止まってしまう。これは、知識負債と同じ「気づかないうちに蓄積される受動的なプロセス」そのものである。
まとめ
「知識が増えるほど使えなくなる」という感覚は、気のせいでも整理不足でもない。情報過多と選択のパラドックス、データ墓場とコンテキストの喪失、知識負債とサイロ化、そして転用可能性のパラドックス。4つの異なる現象が、それぞれ別の角度からこの不便さを生んでいる。
共通しているのは、蓄積は自動で進むが、使える状態に保つことは能動的な処理を要するという構造だ。圧縮、抽象化、構造化、文脈抽出という4つの処方箋は、脳の忘却機能から着想を得た、蓄積と使える状態化のギャップを埋めるための具体的な手当てになる。
冒頭の「前にも調べた気がするのに出てこない」という感覚も、蓄積した情報のどこかに、この4つの処理のどれかが欠けているサインかもしれない。自分の知識管理は、4つの現象のどれに一番心当たりがあるだろうか。
あたまこの記事が役に立てば嬉しいです。よかったら他の記事も見てみてくださいね。
関連記事

コメント