
「緊急資金」で検索しても0件|SQLite FTS5とunicode61トークナイザの罠
「ハイブリッド検索対応」と謳うローカル検索ツールで、日本語のキーワードだけ0件になった経験はないだろうか。
- なぜ日本語のキーワード検索だけ0件になるのか(原因の仕組み)
- trigram・形態素解析・ICU・外部拡張、4つの対処法の違いと選び方
- トークナイザを直せない場合の代替設計
Obsidianのナレッジベース(622ファイル)向けに、qmdというローカル検索ツールで埋め込みモデルの比較実験をしていたときのことだ。qmdはBM25(語彙検索)とベクタ検索のハイブリッドを謳っている。ところが、日本語の言い換えクエリ12問でBM25を測ったら、全問が圏外だった。P@1もP@3もP@5も、揃って0.000。埋め込みモデル側の実測結果は以下の記事にまとめてあるので、ここではBM25側の原因と対処法だけを書く。
原因:unicode61トークナイザは日本語を分割できない
原因を追ったら、全文検索インデックスの定義にあった。
CREATE VIRTUAL TABLE documents_fts USING fts5(
    filepath, title, body,
    tokenize='porter unicode61'
)
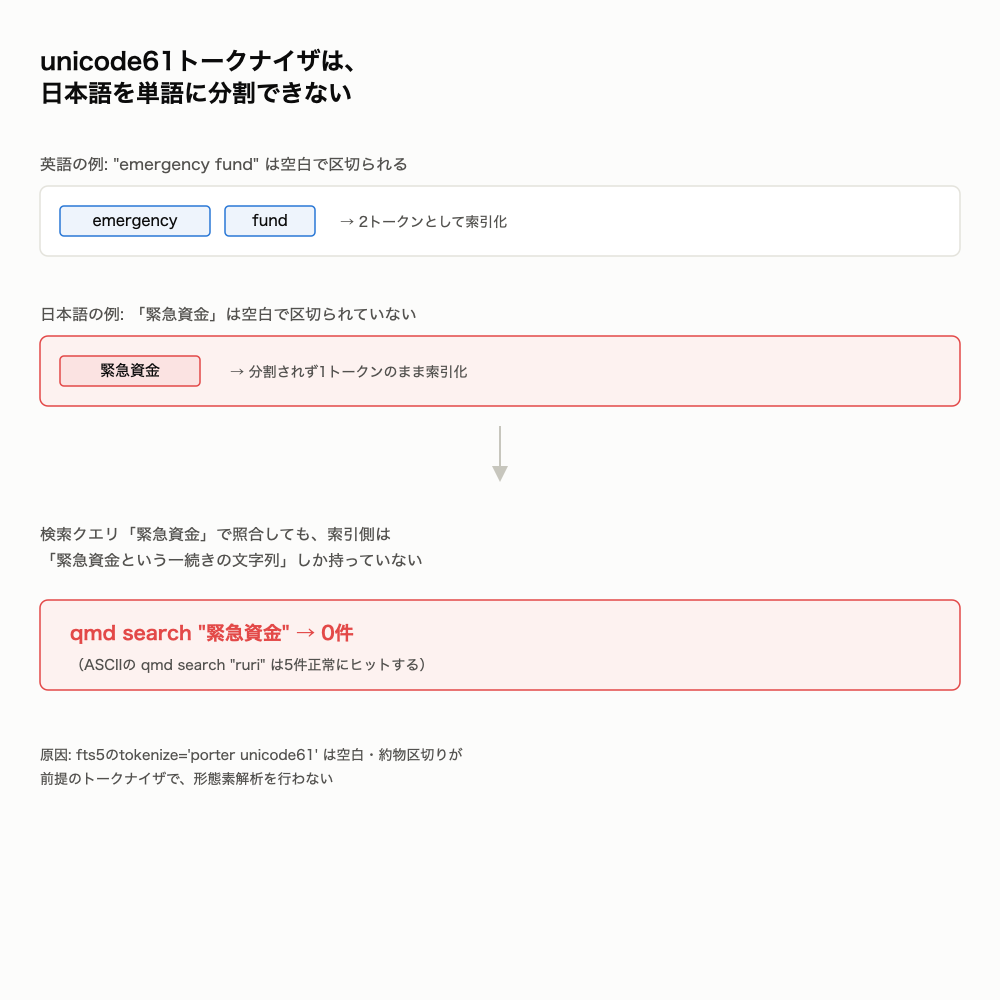
unicode61はUnicodeの空白と約物で単語を区切るトークナイザだ。英語なら問題ない。だが日本語は単語が空白で区切られていないので、文全体がひとつのトークンとして索引されてしまう。だから「緊急資金」で検索しても何にもヒットしない。
実際に確かめると、qmd search "緊急資金" は0件。ASCIIの qmd search "ruri" は5件正常に返る。
 あたま
「ハイブリッド検索対応」という謳い文句を見て、日本語でも当然両方効いていると思い込んでいました。実際に検索してみるまで、BM25側が丸ごと死んでいることに気づかなかったのが正直なところです。
これは日本語でローカル検索ツールを使うとき、かなり広く当てはまる落とし穴だと思う。「ハイブリッド検索対応」と書いてあっても、日本語では片肺で動いている可能性がある。形態素解析ベースのトークナイザを組み込んでいるかどうかは、確認する価値がある。
対処法:trigram・形態素解析・ICU・外部拡張の4択
unicode61の限界は、SQLite FTS5を使う側では広く知られた問題であり、対処法もいくつか存在する。
- trigramトークナイザ:SQLite 3.34.0(2020年)以降のFTS5に`tokenize=’trigram’`が搭載されている。3文字単位でインデックスするため、単語境界の判定なしにCJKの部分文字列マッチができる。追加のロードコストがゼロで実装も`CREATE VIRTUAL TABLE`の一行を変えるだけと手軽な一方、精度では形態素解析に劣る
- 形態素解析の事前分割:MeCab・kuromoji・Janomeなどで文を形態素に分割し、あらかじめ空白区切りの文字列にしてからINSERTする。索引自体は`unicode61`のまま、入力側で日本語を「疑似的に空白区切りの英語」に変換する形になる。精度は高いが、インデックス構築のパイプラインに形態素解析器を組み込む手間が増える
- ICUトークナイザ:`SQLITE_ENABLE_ICU`フラグ付きでSQLiteをビルドし直すと、ICU(International Components for Unicode)ベースの単語分割トークナイザが使える。多言語対応の単語境界判定ができる一方、SQLiteの再ビルドという追加コストが要る
- 外部拡張トークナイザ:sqlite-vaporettoのように、外部の形態素解析器をFTS5のトークナイザとして登録する拡張も存在する。形態素解析の精度をSQLite内で完結させたい場合の選択肢になる
「unicode61かtrigramか」は二者択一ではなく、両方を持たせるハイブリッド運用が実務では選ばれることも多い。まず試すならtrigramが手軽だ。追加コストゼロで導入でき、CREATE VIRTUAL TABLEの一行を変えるだけで日本語のヒット率が改善する。
自分が選んだ対処法:疎検索の再現率をwikilinkで補う
今回のqmdは、内部のトークナイザ設定をユーザー側から差し替えられる作りにはなっていなかった。ソースを改造すればtrigramへの切り替えは可能だが、比較実験の目的(埋め込みモデルの精度検証)からは外れる作業になる。
そこで、疎検索(BM25)で再現率を補えないなら、別の手段で補うことにした。幸いObsidianのVaultにはwikilinkという人間が引いた関連の網がある。埋め込み検索でヒットしたページから、そこに張られたリンクを辿って周辺のページも合わせて集める、という設計に切り替えた。
トークナイザという道具の限界を、道具を直さずに設計側で吸収した格好になる。ツール側の設定を変えられない・変える手間が見合わないときは、検索の外側(人間が引いたリンク構造など)で再現率を補うという選択肢も検討に値する。
自分と同じようにローカル検索ツールを日本語コンテンツに使っていて、キーワード検索だけ妙にヒットしないと感じたら、まずtokenize=の設定を確認してみてほしい。原因はunicode61であることが多い。
関連記事
出典(2026年8月時点で確認)

コメント