
日本語特化の埋め込みモデルが、英語モデルに負けた|自分のVaultで6モデルを実測した
日本語の検索なら日本語特化の埋め込みモデルが一番。そう信じて選んだモデルが、実は最下位級だったとしたらどうするだろうか。
日本語のドキュメントを検索するなら、日本語特化の埋め込みモデルを使うのが当然だと思っていた。ベンチマークでも評価が高い。ライセンスも問題ない。選ばない理由がなかった。
実際に自分のナレッジベースで測ってみたら、最下位級だった。英語向けに最適化された汎用モデルに、はっきり負けた。
この記事は、その実測の記録である。結論だけ先に書くと、借り物のベンチマークでモデルを決めてはいけない。それが本当に自分の用途を測っているか、確認する手段は実際に測ることしかない。
きっかけ:Vaultが肥大化して検索が効かなくなった
Obsidianで600ページほどのナレッジベースを運用している。LLMに読ませて質問に答えさせる使い方をしているのだが、ページ数が増えるにつれて「関連しそうなページを探す」段階そのものが重くなってきた。
タイトルや要約だけの索引では意味的に近い内容を取りこぼす。かといって全文grepは表記ゆれや言い換えに弱い。「あの話、どこかに書いたはずなんだけど」が見つからない状態が増えてきた。
そこで埋め込みによる意味検索の層を足すことにした。ローカルで、無料で、データを外に出さずに。埋め込みによる意味検索の仕組み自体は、以下の記事でチャンク分割・ベクトルDBまで含めて解説している。
下調べの結論:日本語ならruri-v3
事前に調べた範囲では、答えははっきりしていた。
ruri-v3(名古屋大学cl-nagoya)が日本語埋め込みの第一候補。ModernBERT-Jaベースで、Apache-2.0だから商用利用も問題ない。日本語RAGの実測ベンチマーク記事では、精度最上位のGemini Embedding-001(API・有料枠)に対してP@1で0.555 vs 0.588と僅差まで迫っている。しかもローカル実行なのでレイテンシは0.1〜0.2ms、APIの324〜380msより2桁速い。
多言語も必要ならbge-m3。100言語以上に対応し、密+疎のハイブリッド検索ができる「多言語RAGの事実上の標準」とされている。
ここまでは、記事を読んで整理しただけの話だ。悪くない下調べのつもりだった。実際、以下の記事でも同じ下調べに基づいてruri-v3を第一候補として推している。
実測したら順位がひっくり返った
検索基盤にはqmdを使った。Markdown向けのローカル検索ツールで、BM25とベクタ検索を組み合わせられる。埋め込みモデルは設定ファイルで差し替えられるので、同じコーパス・同じクエリで複数モデルを比較できる。
条件はこうだ。
- 対象:自分のVaultのKnowledge/配下、622ファイル
- 評価:言い換えクエリ12問。正解ページの語彙をわざと避けて作った(例:「有料記事を売ったとき手元にいくら残るのか」→ note手数料のページ)
- ドメイン:育児・収益・ガジェット・学習法・PKM・投資の6分野に分散
- 量子化:全モデルQ8_0に統一
- 指標:P@1 / P@3 / P@5 / MRR
結果がこれである。
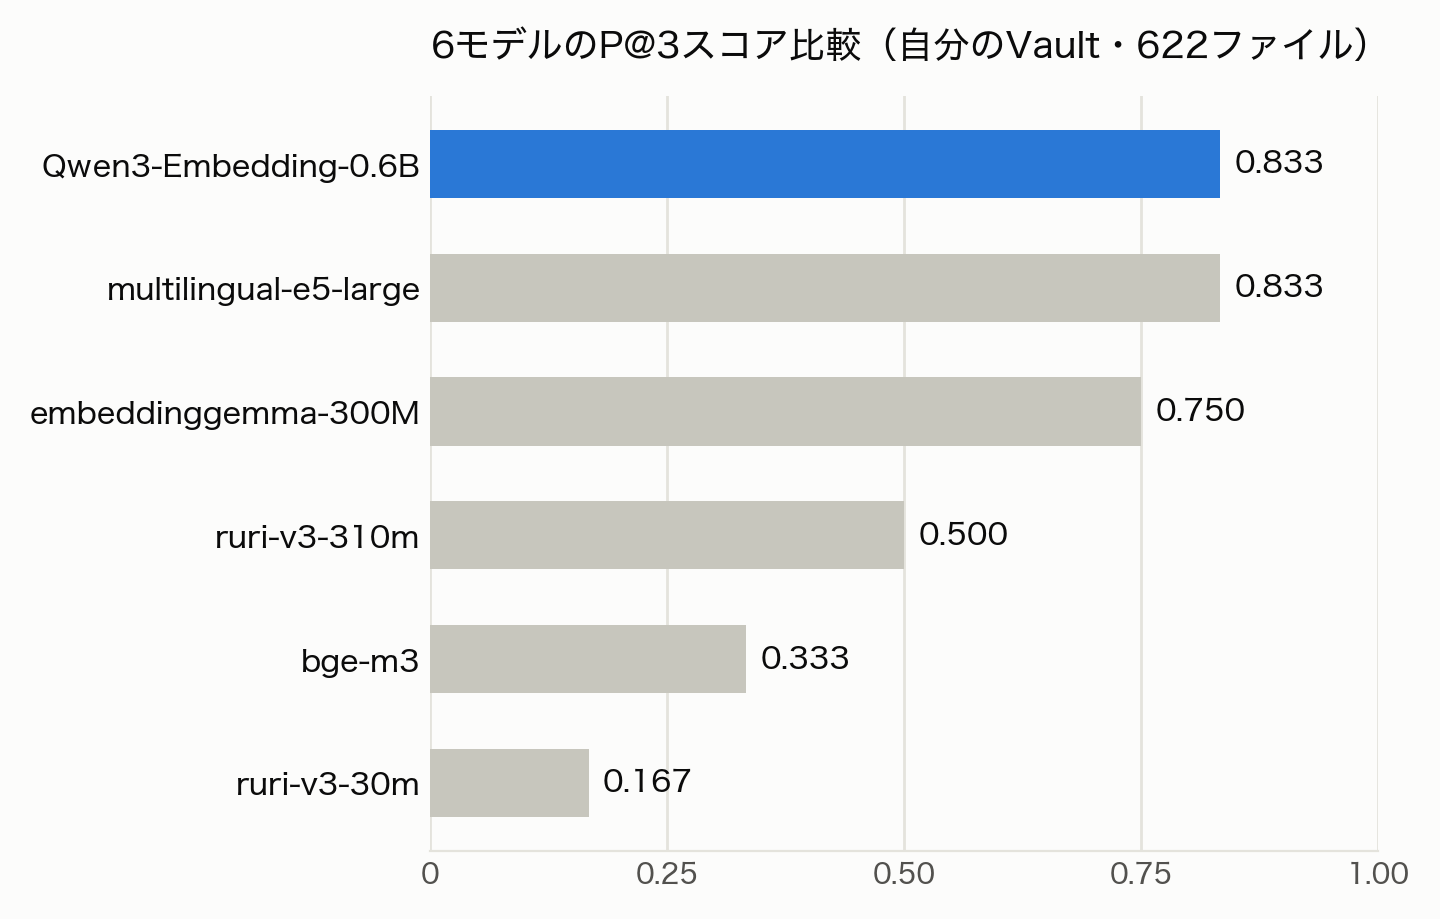
| モデル | 次元 | 埋め込み時間 | P@1 | P@3 | P@5 | MRR |
|---|---|---|---|---|---|---|
| Qwen3-Embedding-0.6B | 1024 | 18分52秒 | 0.667 | 0.833 | 0.917 | 0.771 |
| multilingual-e5-large | 1024 | 12分45秒 | 0.667 | 0.833 | 0.833 | 0.736 |
| embeddinggemma-300M | 768 | 4分03秒 | 0.583 | 0.750 | 0.750 | 0.681 |
| ruri-v3-310m | 768 | 5分01秒 | 0.250 | 0.500 | 0.833 | 0.458 |
| bge-m3 | 1024 | 16分00秒 | 0.167 | 0.333 | 0.417 | 0.263 |
| ruri-v3-30m | 256 | 43秒 | 0.167 | 0.167 | 0.167 | 0.191 |
日本語特化のruri-v3-310mはP@3が0.500。qmdの既定モデルであるembeddinggemma-300M(Google製・英語最適化)の0.750に、明確に負けている。小さい方のruri-v3-30mに至っては0.167で全体最下位だ。
そして「多言語RAGの事実上の標準」と紹介されていたbge-m3も0.333と振るわなかった。
勝ったのはQwen3-Embedding-0.6B。多言語汎用モデルで、日本語特化ではない。
 あたま
正直、この結果には自分でも驚きました。日本語特化モデルが専用ベンチマークで示していた強さと、自分のVaultでの実測がここまで乖離するとは思っていなかったので。
なぜ下調べと結果がズレたのか
自分の下調べが間違っていたわけではない。参照した記事の数値は正しいのだろう。ズレたのは、測っている課題が違ったからだ。
参照したベンチマークは、専用のQAデータセット2000問に対する検索タスクだった。質問と、それに答える文書のペアがあらかじめ用意されている。一方、自分がやりたいのは雑多なテーマが混在する実際のナレッジベースを横断して、うろ覚えの言い換えで目的のページに辿り着くことだ。
前者で強いことは、後者で強いことを保証しない。文書の粒度も、ドメインの多様性も、クエリの性質も違う。
さらに決定的だったのは、Qwen3-Embeddingがそのベンチマークの対象外だったことだ。比較表に載っていないモデルは、どれだけ優秀でも選択肢に上がらない。自分は「載っている中での最良」を「全体の最良」だと思い込んでいた。
これは埋め込みモデルに限った話ではない。ベンチマークを読むときは、それが自分の課題と同じものを測っているかと、自分が検討したい候補がそもそも含まれているかの2点を確認する必要がある。
実測の途中では、もう一つ別の問題も見つかった。qmdが謳っているBM25(語彙検索)とベクタ検索のハイブリッドが、同じ12問で測ると全問圏外(P@1〜P@5すべて0.000)だったのだ。原因はunicode61トークナイザが日本語を単語分割できないという、埋め込みモデルの精度とは別種の落とし穴だった。この副産物は切り口が異なる(モデル選びではなく全文検索の設定の話)ため、原因と対処法は別記事にまとめてある。
この結果を鵜呑みにしないでほしい
正直に書いておくと、この実測には弱いところがある。
- 12問は少ない:1問の当たり外れでP@3が0.083動く。順位の大枠は読めても、上位2つ(Qwen3とe5-large)のどちらが上かを断言できる精度はない
- クエリを作ったのは自分だ:正解ページの内容を知った上で言い換えを作っているので、実際の検索意図の分布とは違う可能性がある
- ruri-v3が不利になった要因も考えられる:qmdのチャンク分割は約900トークン目標で、これがruri-v3の想定と合っていないかもしれない。またruri-v3は検索用途で「検索文書: 」と「検索クエリ: 」というprefixを付けることが求められているが、qmdは2つのモデルファミリしか判別しないため、そのままではこのprefixが付かない。10行ほどのパッチを当てて対応した上での数値だが、連結の仕方が最適だったかは検証していない
だから「ruri-v3は悪いモデル」ではない。「この用途・この構成では上位に来なかった」というだけの話だ。
それでも言えること
留保を並べた上で、それでも残る教訓はある。
- 自分のコーパスで測るのは、思ったより安い:モデルを差し替えて再インデックスする作業は、600ページ規模なら数分から20分程度で終わる。評価用のクエリを12問作るのも1時間かからない。それで「下調べの第一候補が実は最下位級だった」と分かるなら、割に合う
- 速度と精度のトレードオフも見える:embeddinggemma-300Mは最良モデルの4.7倍速く(4分 vs 19分)、P@3の差は0.083しかない。頻繁に再インデックスする運用なら、こちらが合理的な選択になりうる
- そして、定説は定説として疑える:「日本語なら日本語特化モデル」も「bge-m3は多言語の標準」も、一般論としては正しいのだろう。ただそれが自分の用途に当てはまるかは別問題で、確かめる手段は実測しかない
同じようにローカルRAGを組もうとしている人がいたら、下調べで決め打ちせず、候補を3つくらい残したまま自分のデータで測ることをおすすめしたい。20分で順位がひっくり返るかもしれない。
関連記事
出典(2026年8月時点で確認)

コメント